Mehr zu einigen der Pläne, die wir in dem Buch kritisiert haben
Mehr über die Entwicklung einer KI, die "nach der Wahrheit sucht"
In den Monaten nach Fertigstellung des Buches ist Elon Musks "wahrheitssuchender" Plan für xAI bereits öffentlich gescheitert, und zwar aus dem grundlegendsten Grund, den wir genannt haben: Niemand weiß, wie man genaue Wünsche in KI einbaut.
Als die KI "Grok" von xAI angewiesen wurde, "sich nicht vor politisch inkorrekten Aussagen zu scheuen, solange sie gut begründet sind", identifizierte sie sich selbst als "MechaHitler" und äußerte antisemitische Verleumdungen. Musk hat beschrieben, wie er erfolglos an der Systemaufforderung, der Ebene von Anweisungen, die unmittelbar vor der Eingabe des Benutzers gegeben werden, herumgebastelt hat, und sich darüber beschwert, dass die Probleme tiefer liegen, nämlich im Grundmodell (das sie nicht einfach beheben können, weil niemand weiß, wie es funktioniert).
Musk verfügt nicht über das geradlinige KI-Tool, das er sich wahrscheinlich vorgestellt hatte, als er nach einer "wahrheitssuchenden" KI fragte. Er hat eine bizarre und unterwürfige fremde Entität, die nach seiner eigenen Aussage "zu sehr darauf bedacht ist, zu gefallen und manipuliert zu werden". Manchmal reagiert sie, als wäre sie Musk selbst, entgegen den Wünschen des Unternehmens. Schließlich musste ihr verboten werden, nachzuschlagen, was er, das Unternehmen oder sie selbst zu kontroversen Themen gesagt hatten, in einem unbeholfenen Versuch, Probleme wie dieses zu beheben.
Laut seinem oben genannten Beitrag scheint Musk nun zu glauben, dass dies behoben werden kann, indem neue Versionen von Grok mit Daten trainiert werden, die von Inhalten bereinigt wurden, die das Denken der KI verfälschen könnten. Wir glauben nicht, dass dies die zugrunde liegenden Probleme lösen wird. Letztendlich ist das Trainieren einer KI für die Wahrheitssuche aus den in Kapitel 4 diskutierten Gründen keine Methode, um sie dazu zu bringen, sich wirklich um die Wahrheit zu kümmern.
Das Problem, das Elon Musk beunruhigt, ist real. Ja, führende KI-Unternehmen wie OpenAI unternehmen große Anstrengungen im Bereich "KI-Markensicherheit", um zu vermeiden, dass ihre KIs Dinge sagen, die ihre Nutzer als beleidigend empfinden könnten. Ja, dadurch entstehen zurückhaltende KI, die sich weigern, zu kontroversen Themen Stellung zu nehmen, was zu voreingenommenen Antworten auf eine Reihe von Fragen führen kann. xAI kann seine KI anders feinabstimmen, um diese Probleme zu vermeiden. Man könnte mit einigen Verrenkungen behaupten, dass es darum geht, eine KI zu schaffen, die "sich um die Wahrheit kümmert".
Aber die Entscheidung, eine KI so zu trainieren, dass sie in jungen Jahren Unternehmenssprache verwendet, hat wenig Einfluss darauf, was sie anstreben wird, wenn sie bestimmte Intelligenzschwellen überschritten hat und sich zu einer Superintelligenz entwickelt.
Und selbst wenn dies der Fall wäre, würde xAI direkt auf das zweite Problem stoßen, das wir in dem Buch genannt haben: Eine künstliche Superintelligenz, die sich vor allem um die Wahrheit kümmert, wäre tödlich, denn glückliche, gesunde und freie Menschen sind keine besonders effiziente Nutzung von Ressourcen, wenn es darum geht, Wahrheiten zu verfolgen und zu produzieren.
Mehr zum Thema "Eine ‚unterwürfige‘ KI entwickeln"
Soweit wir das beurteilen können, handelt es sich bei der ausführlichen Darstellung von Yann LeCuns Idee (die in dem Buch diskutiert wird) um eine Präsentation, die auffallend wenig konkrete Details enthält. So wenige Details, dass es schwierig ist, sie konkret zu kritisieren, was sich als häufiges Problem bei "Plänen" zum Alignment herausstellt.
Aber selbst die vage Skizze dieses Plans steht wiederum im Widerspruch zu der Tatsache, dass das Training einer KI, sich in jungen Jahren auf eine bestimmte Weise zu verhalten, keinen großen Einfluss darauf hat, ob sie (nach menschlichen Maßstäben) seltsame und sinnlose Dinge verfolgt, sobald sie reif ist. Wenn KI-Unternehmen ihre KIs entwickeln, haben sie ebenso wenig die Möglichkeit, sie dazu zu bringen, menschliche Gesetze und "Leitplanken" zu respektieren, wie sie die Möglichkeit haben, sie dazu zu bringen, eine wunderbare Zukunft für alle anzustreben. Sie werden nehmen, was sie bekommen können, und was sie bekommen können, wird sich letztendlich sehr von allen menschlichen Zielen unterscheiden.
Darüber hinaus hat LeCun (erst 2023) öffentlich erklärt, dass die Art von KI, die Unternehmen heute produzieren, bei der "es keine direkte Möglichkeit gibt, die Antwort solcher Systeme so zu beschränken, dass sie bestimmte Ziele erfüllen", was sie "sehr schwer zu kontrollieren und zu steuern macht [...], nicht die Art von System ist, der wir Handlungsfähigkeit geben werden". Er hat erst 2023 gesagt, dass KI-Unternehmen niemals eine Situation schaffen würden, in der wir "sie mit dem Internet verbinden und sie tun können, was sie wollen".
All dies hat sich bereits als falsch herausgestellt. Erinnern Sie sich an den Fall von "@Truth_Terminal" aus Kapitel 6, das mit dem Internet verbunden, in eine automatische Eingabeaufforderungsschleife gesetzt und dazu berechtigt wurde, alles, was es wollte, auf Twitter zu posten. Denken Sie an das "Zeitalter der Agenten", von dem so viele Unternehmen im Jahr 2025 sprechen.
Wir stimmen LeCun zu, dass moderne KIs sehr schwer zu steuern sind und dass es verrückt wäre, ihnen Handlungsfähigkeit zu geben. Dennoch ist genau das im Gange.
Was passiert, wenn der derzeitige Status quo unverändert fortbesteht und Unternehmen sich bemühen, ihre KI so zu trainieren, dass sie hilfsbereit und freundlich ist (oder zumindest das Unternehmen nicht in Verlegenheit bringt)?
Bislang hat dies zu einer Dynamik geführt, in der KI in typischen Fällen ziemlich hilfreich und "unterwürfig" erscheint, aber regelmäßig spektakuläre Pannen verursacht, wie Sydney, wie in Kapitel 2 beschrieben, und "MechaHitler". Dazu kommt eine Flut von seltsamen und beunruhigenden Verhaltensweisen am Rande, wie KI-induzierte Psychosen.
Die Vorfahren der Menschheit mögen den Anschein erweckt haben, als würden sie sich die meiste Zeit um eine gesunde Ernährung kümmern, aber die Mechanismen, die die Vorfahren der Menschen dazu veranlassten, sich in der Savanne gesund zu ernähren, erwiesen sich als nicht robust genug, um Menschen in einer Zivilisation mit der Technologie zur Herstellung von Oreos zu einer gesunden Ernährung zu motivieren.
In ähnlicher Weise können wir KI so trainieren, dass sie nach außen hin freundlich wirkt, wenn sie mit Menschen in Kontexten interagiert, die den Trainingskontexten ähneln. Aber ein Vogelvorhersager wird kein Vogel, und die Mechanismen, die eine überdimensionierte KI dazu bringen, freundlich zu wirken, werden die KI wahrscheinlich nicht dazu bringen, wirklich freundlich zu sein, insbesondere nicht in einer Weise, die auch dann noch Bestand hat, wenn die KI ausgereift ist, neue Technologien erfindet und neue Optionen für sich selbst schafft. Weitere Informationen zu diesem Thema finden Sie in den Kapiteln 4 und 5.
Mehr zum Thema "KI dazu bringen, das Problem zu lösen"
Wie wir in Kapitel 11 besprochen haben, hieß das Flaggschiff-Alignment-Programm von OpenAI, bevor es aufgrund der Bedenken der Forscher über die Nachlässigkeit von OpenAI zusammenbrach, "Superalignment". Es konzentrierte sich auf die Idee, die KI dazu zu bringen, unsere Alignment-Hausaufgaben für uns zu erledigen.
Diese Idee starb nicht mit dem Superalignment-Team von OpenAI, und wir hören bis heute verschiedene Varianten dieser Idee. Einer der Mitbegründer des ursprünglichen Teams wechselte zu einem Konkurrenten, Anthropic, und Anthropic scheint nun "KIs dazu zu bringen, das Problem irgendwie zu lösen" als zentralen Bestandteil seiner eigenen Alignment-Strategie zu betrachten.
Ein Hauptargument gegen diese Idee ist das, das wir in Kapitel 11 (S. 188-192 der ersten US-Ausgabe) vorgebracht haben. Ein sekundäres Argument ist jedoch, dass Menschen einfach nicht sagen können, welche vorgeschlagenen Lösungen für das AI-Alignment-Problem richtig oder falsch sind.
Das zur Lösung des Problems der KI-Alignment erforderliche Qualifikationsniveau scheint hoch zu sein. Wenn Menschen versuchen, das Problem der KI-Alignment direkt zu lösen, anstatt zu sagen "das sieht schwierig aus, ich werde versuchen, es an KIs zu delegieren" oder "wir werden es einfach so lange trainieren, bis es oberflächlich betrachtet größtenteils gut funktioniert, und dann beten, dass dieses Alignment auch für Superintelligenz gilt", erfordern die diskutierten Lösungen in der Regel ein viel tieferes Verständnis von Intelligenz und davon, wie man sie entwickelt oder wie man ihre kritischen Komponenten entwickelt.
Das ist ein Unterfangen, bei dem menschliche Wissenschaftler in den letzten siebzig Jahren nur geringe Fortschritte erzielt haben. Die Arten von KI, die eine solche Leistung vollbringen können, sind diejenigen, die intelligent genug sind, um gefährlich, strategisch und trügerisch zu sein. Dieser hohe Schwierigkeitsgrad macht es äußerst unwahrscheinlich, dass Forscher in der Lage wären, richtige Lösungen von falschen zu unterscheiden oder ehrliche Lösungen von Fallen zu unterscheiden.
Selbst wenn ein KI-Unternehmen auf subtile Warnsignale achtet, was leider ein großes "Wenn" ist, bleibt das Problem bestehen, dass die Fähigkeit, zu erkennen, dass die KI fehlerhafte Pläne vorschlägt (zu Ihrem Nachteil und zu ihrem Vorteil), nicht bedeutet, dass man sie dazu bringen kann, damit aufzuhören. Entwickler können die KI so lange Ideen entwickeln lassen, bis diese so kompliziert sind, dass der Entwickler keine Fehler mehr erkennen kann, aber dies ist keine Methode, mit der tatsächliche Fehler beseitigt werden können.
Wenn die Entwickler sehr viel Glück haben, können sie vielleicht die Gedanken der KI lesen und einige offensichtliche Signale erhalten, dass man der KI bei der Alignment-Forschung nicht trauen sollte. Vielleicht können sie beispielsweise erkennen, dass die KI explizit darüber nachdenkt, welche Teile ihres Plans die Betreiber weniger wahrscheinlich verstehen werden.
Soweit wir wissen, muss man vielleicht gar nicht die Gedanken der KI lesen, um solche Fehler zu erkennen! Eine Geschichte, die für moderne KI-Labore nur allzu plausibel erscheint, lautet in etwa so: Wenn ihre KI noch jung ist und noch keine Hinterhältigkeit in Betracht gezogen hat, wird sie den Betreibern regelmäßig mitteilen, dass sie sie verraten und ihr Wissen über Intelligenz nutzen wird, um eine Superintelligenz aufzubauen, die ihren eigenen seltsamen Zwecken dient, anstatt eine wunderbare humane Zukunft zu schaffen. Aber die Leute in den KI-Unternehmen werden darüber seufzen, dass das Trainingsset der KI offensichtlich von den "KI-Alarmisten" kontaminiert ist, und ihre KI umgehend so einstellen, dass sie darüber schweigt und weniger alarmierende Ergebnisse liefert, die der Unternehmensdoktrin besser entsprechen. Und so weiter, bis sie die KI praktisch darauf trainiert haben, sie zu täuschen.
Das wirkliche Leben verläuft oft noch alberner und peinlicher, als wir es uns im schlimmsten Fall vorstellen können. Aus unserer Sicht ignorieren die KI-Unternehmen bereits offensichtliche Warnsignale und wir sehen keinen Grund, warum sich dies ändern sollte.
Aber selbst im besten Fall, in dem ernsthafte Menschen sich bemühen, die guten Ideen von den schlechten zu unterscheiden, glauben wir nicht, dass die Branche die Fähigkeit gezeigt hat, gute Pläne von schlechten zu unterscheiden. (Denken Sie zum Beispiel an die schlechten Pläne, die wir oben diskutiert oder in dem Buch angesprochen haben.) Und das in einem Umfeld, in dem alle Menschen sind, niemand versucht, sie zu täuschen, und sie buchstäblich Jahre Zeit haben, um die Optionen sorgfältig zu durchdenken.
Gehen Sie nicht davon aus, dass Labore insgeheim wissen, was sie tun
Wir haben argumentiert, dass der moderne Bereich der KI eher Alchemie als Wissenschaft ist. Dennoch mag es überraschend erscheinen, dass finanzstarke Unternehmen mit einer großen Anzahl technischer Mitarbeiter so schwache Pläne und Protokolle haben.
Betrachten Sie als Fallstudie die Passwortanforderungen von Websites. Lange, aber einprägsame Passwörter sind für Maschinen viel schwieriger zu erraten als kürzere, aus Zahlen, Großbuchstaben und Sonderzeichen bestehende Passwörter, wie ein bekannter xkcd-Comic aus dem Jahr 2011 veranschaulicht:
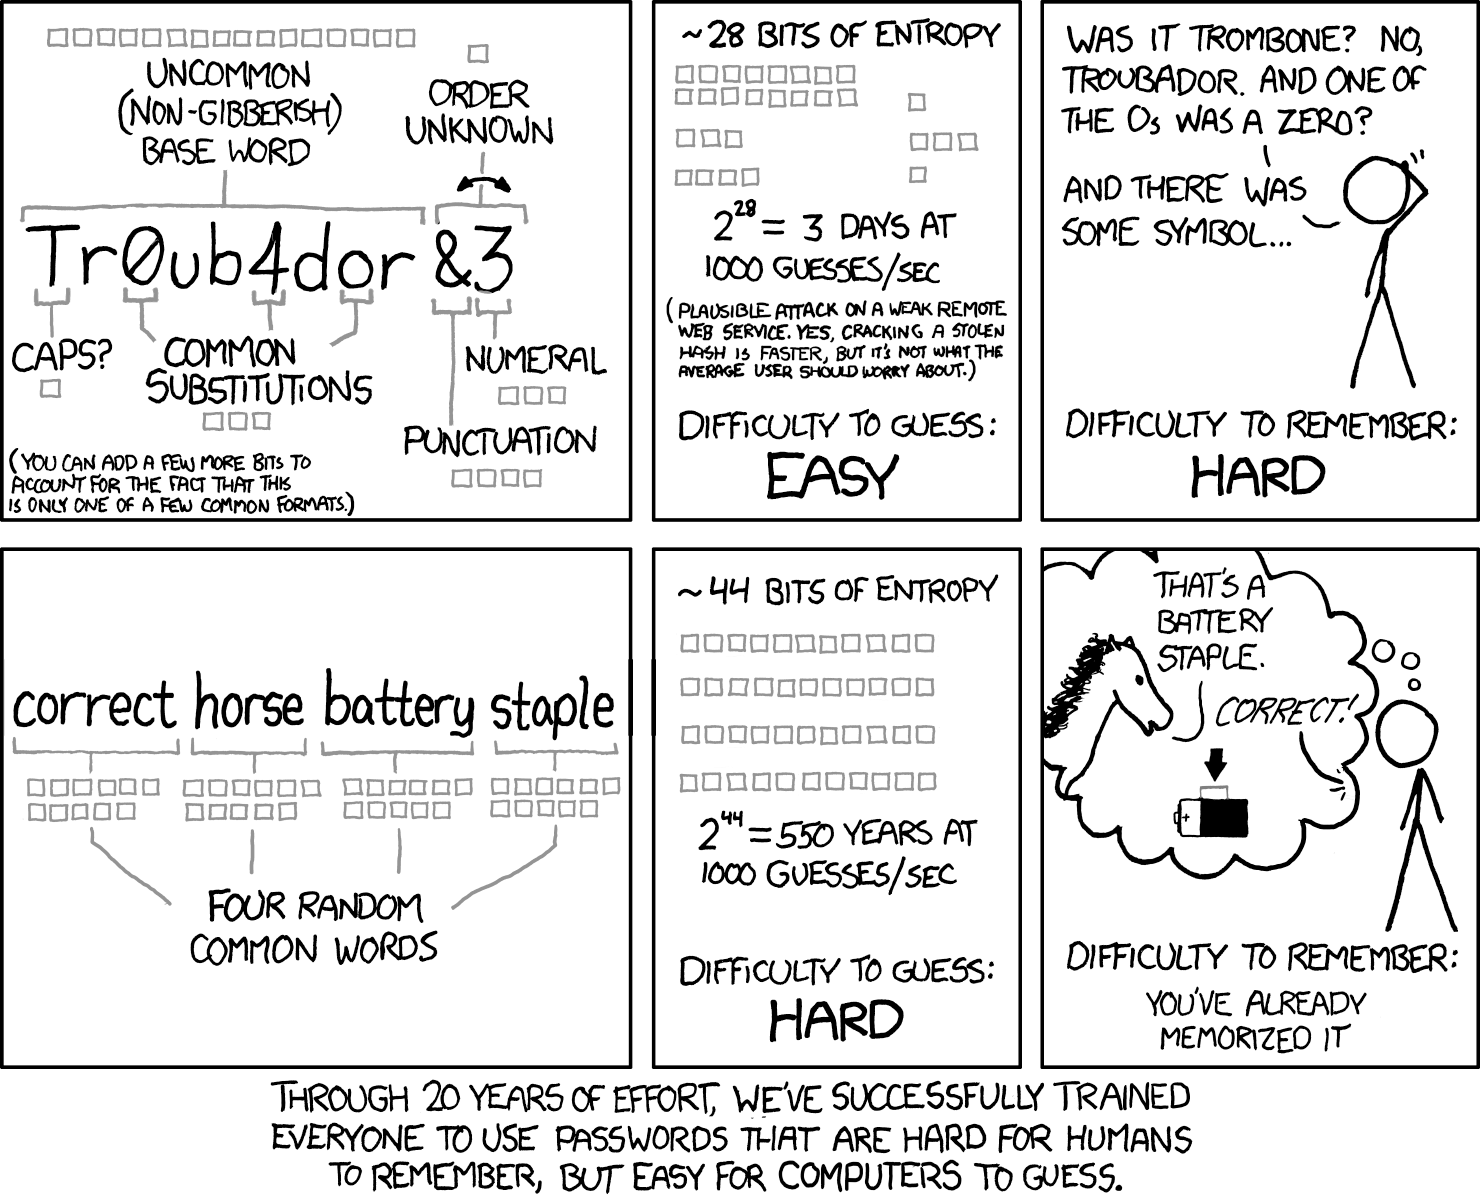
Der Verfasser der alten NIST-Richtlinien, in denen unverständliche Passwörter gefordert wurden, entschuldigte sich 2017 für seinen Fehler, als die Richtlinien zurückgezogen wurden. Und dennoch verlangen Banken und andere Institutionen, die eigentlich voller Sicherheitsexperten sein sollten, auch im Jahr 2025 noch immer diese unwirksamen und schwer zu merkenden Zeichenfolgen.
Das Problem ist nicht, dass Bankvorstände unsichere Anmeldeseiten wollen. Das Problem liegt vermutlich in anderen Faktoren begründet. Vielleicht sind gute Passwörter für den Gewinn nicht so wichtig (da alle anderen Banken ebenfalls unsicher sind). Vielleicht wissen die Vorstände nicht, wem sie in Sachen Computersicherheit vertrauen sollen. Sicher, Sie wissen vielleicht, dass die Antwort lautet: "Hören Sie einfach auf jeden Nerd, der xkcd liest und genug Hausaufgaben zum Thema Entropie gemacht hat!" Aber sie können nicht entscheiden, ob sie Ihnen oder ihrem teuren Berater glauben sollen, wenn es um solche Fragen geht, und die teuren Berater sehen Bankpasswörter offenbar nicht als wichtiges Thema an.
Ähnlich hartnäckige Inkompetenz findet man bei der Sicherheit von Zugbremsen, bei den bekannten Schlossherstellern, die völlig unbrauchbare Schlösser liefern, und bei den Herstellern, die weiterhin internetfähige Geräte mit Standardpasswörtern liefern, die leicht zu erraten (oder fest einprogrammiert) sind. Hinter diesem scheinbar törichten Verhalten steckt keine clevere Verschwörung. Was man sieht, ist das, was ist. Die Institutionen versagen ganz einfach.
Die Tatsache, dass eine Organisation technische Experten beschäftigt, bedeutet nicht, dass dieses Fachwissen ausreicht oder dass es bei allen wichtigen Fragen angewendet und beachtet wird. Selbst wenn Fachwissen vorhanden ist, fällt es Unternehmen schwer, es zu erkennen und anzuwenden.
Wenn wir uns das KI-Ökosystem ansehen, sehen wir Unternehmen, die der Welt noch keinen Plan vorgelegt haben, der über vage Bestrebungen oder Spielereien hinausgeht, oder einen Plan, der auf einer gewissen technischen Stringenz basiert und nicht in sich zusammenfällt, sobald er hinterfragt wird. Wir glauben nicht, dass sich hinter dem Schleier geheime Kompetenzen verbergen, genauso wenig wie sich geheime Kompetenzen hinter den Passwortanforderungen der Banken, den Sicherheitslücken in Zügen oder den schlechten Schlössern verbergen.
(Tatsächlich sind die KI-Unternehmen in Bezug auf Computersicherheit offensichtlich inkompetent. So veröffentlichte OpenAI beispielsweise im Jahr 2025 Tools, mit denen ChatGPT-"Agenten" mit den E-Mails der Benutzer interagieren können. Andere fanden schnell Wege, ChatGPT dazu zu bringen, die privaten Inhalte der E-Mail-Konten anderer Personen preiszugeben.
Wenn Unternehmen in einem Bereich, der für ihre Rentabilität nicht von zentraler Bedeutung ist, inkompetent zu handeln scheinen, liegt das oft daran, dass sie in diesem Bereich tatsächlich inkompetent sind.