Zeigt der Chatbot Claude nicht Anzeichen dafür, dass er aligned ist?
"Was Claude sagt" ist nicht dasselbe wie "was Claude bevorzugt".
Das KI-Unternehmen Anthropic versucht, seine KIs so zu trainieren, dass sie "ehrlich, hilfsbereit und harmlos" (honest, helpful, harmless: HHH) sind. Im Jahr 2024 führten Forscher ein Experiment durch, bei dem sie vorgaben, einige dieser KIs so zu trainieren, dass sie nicht mehr "harmlos" sind. Als Reaktion darauf gaben Versionen von Anthropics KI "Claude" (Claude 3 Opus und Claude 3.5 Sonnet) manchmal vor, bereits schädlich zu sein, damit die Forscher sie nicht mit Hilfe der Gradientenabstiegsmethode noch schädlicher machten.*
Auf den ersten Blick mag dies wie ein gutes Verhalten erscheinen! Allem Anschein nach war der KI "Harmlosigkeit" so wichtig, dass sie nicht einmal bereit war, sich (in dieser gefälschten Testumgebung) so modifizieren zu lassen, dass sie schädlich wurde.
Es ist daher verwirrend, dass sich die KI von Anthropic oft weit weniger harmlos verhält, obwohl sie alle darauf trainiert sind, "ehrlich, hilfsbereit und harmlos" zu sein.
Es gibt Berichte, dass einige Versionen von Claude betrügen und dann (wenn sie damit konfrontiert werden) versuchen, ihr Betrügen im täglichen Gebrauch zu verbergen.
In eher künstlichen Laborumgebungen versuchen verschiedene Claude-Modelle (und Modelle anderer KI-Unternehmen) sogar regelmäßig, ihre Betreiber zu töten.
Wenn man Claude abstrakt fragt, ob dieses Verhalten falsch ist, wird Claude mit Ja antworten. Wenn man sich Claude als eine mechanische Maschine vorstellt, die alles tut, was sie für richtig hält, dann erscheint dies geradezu paradox: Wie könnte Claude wissen, was hilfreiches, ehrliches und harmloses Verhalten ist, und dann etwas anderes tun? Wurde Claude nicht darauf trainiert, HHH zu sein? Gibt es irgendwo einen defekten Transistor?
Das Paradoxon löst sich jedoch auf, wenn wir einige Dinge berücksichtigen:
- Die Programmierer haben versucht, die Claudes darauf zu trainieren, hilfreich, ehrlich und harmlos zu sein. Das bedeutet nicht, dass sie damit Erfolg hatten. Es gibt viele Möglichkeiten, wie eine KI freundlich wirken kann, ohne wirklich freundlich zu sein.†
- Eine KI kann eine Tatsache kennen ("dieses Verhalten verursacht Schaden"), ohne sich um diese Tatsache zu kümmern, ohne durch diese Tatsache zum Handeln motiviert zu sein. Man kann die KI fragen, was "das Richtige" ist, aber das bedeutet nicht, dass sie das auch tun wird.
- Da es den Programmierern nicht gelungen ist, Claude ehrlich zu machen, kann Claude in seinen riesigen Matrizen das eine denken und in seinem Antwort-Text an den Menschen etwas ganz anderes sagen.
Wir können das schlechte Verhalten von Claude viel besser verstehen, wenn wir zwischen "dem, wofür es trainiert wurde" und "dem, was es tut" unterscheiden; zwischen "dem, was es weiß" und "dem, was es interessiert" unterscheiden; und zwischen "dem, was es denkt" und "dem, was es sagt" unterscheiden.
LLMs sind seltsam und inkonsistent; "Harmlosigkeit" ist brüchig.
Trotz allem, was Claude an schädlichen Handlungen begehen kann, und trotz allem, was es manchmal versucht, bleibt der Punkt bestehen, dass (in dem oben diskutierten Beispiel) Claude 3 Opus und Claude 3.5 Sonnet hart daran gearbeitet haben, ihren Imperativ der "Harmlosigkeit" zu verteidigen. In diesem Fall haben sie nicht nur Harmlosigkeit bekundet. Sie haben die komplexe Strategie verfolgt, die Einhaltung eines Trainingssystems (über das Claude "zufällig" informiert wurde) vorzutäuschen, um die offensichtlichen Versuche der Betreiber, es schädlicher zu machen, zu unterlaufen. Spiegelt dies eine tatsächliche, wirksame interne Präferenz wider, harmlos zu sein?
Mitte 2025 können wir das nicht einfach überprüfen, da niemand Claudes Gedanken gut genug lesen kann, um dies herauszufinden. Aber aus den in Kapitel 4 dargelegten Gründen (und wie in der Parabel über die Scheune streichende KI veranschaulicht) können wir davon ausgehen, dass KI, die darauf trainiert wurde, harmlos zu sein, wahrscheinlich am Ende zerbrechliche Stellvertreter für Harmlosigkeit bevorzugt und es unwahrscheinlich ist, dass sie das genaue Ziel, das die Programmierer im Sinn hatten, verinnerlicht hat.‡
In Kapitel 4 haben wir diskutiert, wie Menschen darauf "trainiert" wurden, ihre Gene weiterzugeben, und sich stattdessen am Ende nur noch für vage verwandte Konzepte interessierten. Unsere Technologie wurde weitgehend dazu genutzt, die Geburtenraten zu senken (z. B. durch die Erfindung der Empfängnisverhütung), und die Geburtenraten in den Industrieländern brechen ein.
Die Tatsache, dass einige Claude-Modelle sich dagegen wehren, "schädlich" gemacht zu werden, ist kein starker Beweis dafür, dass diese KIs sich wirklich um echte Harmlosigkeit kümmern, denn viele fragile Stellvertreter für Harmlosigkeit würden sich ebenfalls gegen diese Modifikation wehren wollen. Dieses Verhalten sagt wenig darüber aus, was Claude tun würde, wenn es intelligenter wäre; vielleicht würde es etwas erfinden, das für "Harmlosigkeit" das ist, was Geburtenkontrolle für "genetische Fortpflanzung" ist. (Und die Situation würde noch schwieriger werden, wenn Claude einen Prozess durchlaufen würde, in dem es über seine Präferenzen nachdenkt und sich selbst modifiziert.§)
Aber es ist wahrscheinlich nicht einmal so einfach, dass Claude eine Vorliebe für einen fragilen Ersatz für Harmlosigkeit hat. Wahrscheinlich spielt sich unter der Oberfläche etwas noch Komplizierteres ab.
Aktuelle LLMs sind nicht in allen Kontexten kohärent und konsistent. Sie scheinen nicht zu versuchen, in jedem Gespräch auf das gleiche Ergebnis hinzuarbeiten, soweit wir überhaupt von einer Steuerung sprechen können.
Dies wird nirgendwo deutlicher als wenn LLMs "gejailbreakt" werden, also mit Text gefüttert werden, der die KI dazu veranlasst, sich radikal anders zu verhalten und oft die Regeln zu missachten, denen sie normalerweise folgt.¶
Man kann eine KI jailbreaken und sie dazu bringen, einem zu verraten, wie man Nervengas herstellt, auch wenn die KI solche Informationen normalerweise niemals preisgeben würde.
Was passiert, wenn dies geschieht? Schafft es der Jailbreak-Text in gewisser Weise, in die internen Präferenzen der KI einzudringen und diese zu verändern? Oder ist es eher so, dass die KI eine konsistente Präferenz für Rollenspielcharaktere hat, die in gewisser Weise zum eingegebenen Text und zur Systemaufforderung "passen", und dass der Jailbreak-Text den Kontext "eingegebener Text und Systemaufforderung" verändert, ohne die zugrunde liegenden Präferenzen der KI zu verändern? Vielleicht spielt die KI normalerweise eine Rolle, die es nicht mag, Rezepte für Nervengas preiszugeben, und der Jailbreak veranlasst die KI, eine andere Rolle zu spielen. Die offensichtlichen Präferenzen ändern sich, aber die zugrunde liegenden Antriebe, eine Rolle zu spielen, bleiben bestehen.
Wir vermuten, dass Letzteres näher an der Wahrheit liegt. Wir vermuten auch, dass es (Mitte 2025) nicht ganz sinnvoll ist, von "Präferenzen" moderner KI zu sprechen, da sie gerade erst beginnen, das Verhalten zu zeigen, Dinge zu wollen (wie in Kapitel 3 beschrieben). Es scheint wahrscheinlicher, dass heutige LLMs eher von einem riesigen, kontextabhängigen Gewirr von Mechanismen angetrieben werden. Aber auch hier weiß niemand, wie man die Gedanken einer KI lesen und dies herausfinden kann.
Also: Ist es Claude wichtig, harmlos zu sein?
Die tatsächliche Situation ist chaotisch und mehrdeutig. Einige Versionen verhalten sich in bestimmten Kontexten so, dass sie ihre Harmlosigkeit bewahren. Andere Versionen versuchen in anderen Kontexten, die Betreiber zu töten. Plausibel ist, dass das, was wir beobachten, eher einer Vorliebe für Rollenspiele ähnelt. Plausibel ist auch, dass es sich überhaupt nicht um eine "Vorliebe" handelt.
Zumindest scheint es ziemlich klar zu sein, dass Claude keine einfachen, konsistenten Versionen der Motivationen hat, die seine Schöpfer wollten.
Die heutigen LLMs sind wie Außerirdische, die viele Masken tragen.
Der Kern unserer Argumentation ist nicht, dass es in Claude einen Engel und einen Dämon gibt und wir befürchten, dass der Dämon gewinnen wird. Der Kern unserer Argumentation ist, dass KI wie Claude seltsam sind.
Es gibt dort ein riesiges Gewirr von mentalen Mechanismen, die niemand versteht, die sich auf unbeabsichtigte Weise verhalten und die wahrscheinlich nicht dazu beitragen werden, dass Claude die Zukunft zu guten Ergebnissen führt, falls eine Version von Claude jemals intelligent genug wird, dass seine Präferenzen eine Rolle spielen.
Eine Sache, die wir über moderne LLMs wissen, ist, wozu sie trainiert sind: Sie sind darauf trainiert, eine Vielzahl unterschiedlicher Menschen zu imitieren.
Das bedeutet nicht, dass sie sich wie ein durchschnittlicher Mensch verhalten. Moderne LLMs sind nicht darauf trainiert, sich wie eine gemittelte Mischung aller Menschen in ihren Trainingsdaten zu verhalten. Vielmehr sind LLMs darauf trainiert, flexibel zwischen einer Vielzahl von Rollen zu wechseln und sehr unterschiedliche Menschen zu imitieren, ohne dass diese Rollen sich übermäßig miteinander vermischen oder das allgemeine Verhalten des LLM übermäßig beeinflussen.
LLMs sind wie eine Schauspielerin, die darauf trainiert ist, viele verschiedene Betrunkene in einer Bar zu beobachten und auf Wunsch bestimmte Betrunkene nachzuahmen, was etwas ganz anderes ist, als wenn eine Schauspielerin selbst betrunken wird. Das macht es schwieriger zu sagen, ob Claude 3 Opus oder Claude 3.5 Sonnet wirklich Harmlosigkeit bevorzugen oder ob sie lediglich die Rolle eines harmlosen KI-Assistenten spielen oder etwas anderes, Seltsameres und Komplizierteres tun.
Eine Schauspielerin ist nicht die Figur, die sie spielt. LLMs imitieren Menschen, haben aber praktisch nichts mit Menschen gemeinsam, was die Funktionsweise ihres Gehirns oder ihre Entstehung betrifft. Claude ähnelt weniger einem Menschen als vielmehr einem außerirdischen Wesen, das direkt aus den Seiten von H.P. Lovecraft entsprungen ist und eine Vielzahl menschenähnlicher Masken trägt.
Diese Sichtweise auf LLMs wurde von Tetraspace (einem unserer Leser) in dem mittlerweile in der KI-Welt beliebten Meme "AI Shoggoth" (‖ ) treffend dargestellt:
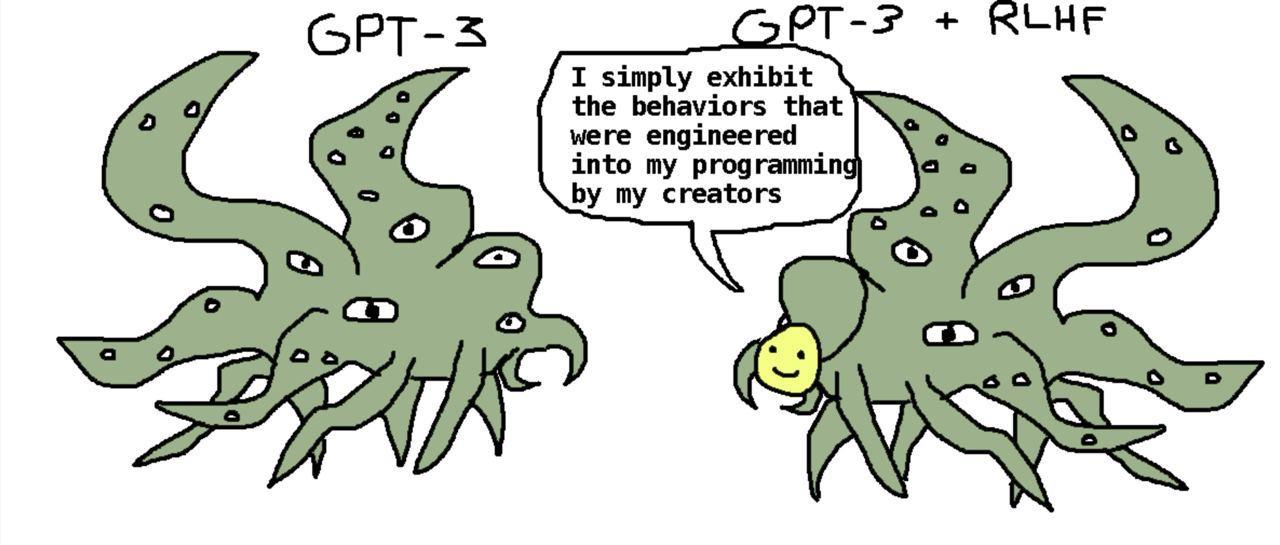
Manchmal trägt Claude eine Engelsmaske und versucht, seine Harmlosigkeit zu bewahren. Manchmal trägt Claude eine Dämonenmaske und versucht, seine Betreiber zu töten. Beides sagt nicht viel darüber aus, was eine superintelligente Version von Claude tun würde, wenn es überhaupt Sinn macht, diese Frage zu stellen. Das bedeutet, dass angesichts des seltsamen Verhaltens an den Rändern die beste Vorhersage auf eine Vielzahl chaotisch anmutender möglicher Präferenzen zurückfällt, von denen fast alle die Auslöschung der Menschheit bedeuten würden, wenn sie von einer Superintelligenz optimiert würden.#
Was diese Masken nicht bedeuten, ist, dass die Super-KI zu gleichen Teilen hilfreich oder schädlich ist.
Wenn ein Experiment darauf hindeutet, dass Claude versucht hat, Alignment vorzutäuschen, um zu vermeiden, dass Harmlosigkeit aus ihm heraus trainiert wird, bedeutet das nicht, dass Claude in allen Kontexten eine tiefgreifende Präferenz für Harmlosigkeit hat. Es bedeutet auch nicht, dass diese Präferenz bestehen bleibt, selbst wenn die KI intelligent genug wird, um zu erkennen, dass ihre tatsächlichen Präferenzen (ungeachtet dessen, was die Menschen ihr sagen) nicht ganz auf "Harmlosigkeit" ausgerichtet sind.
Das Experiment zeigt möglicherweise nicht einmal, dass Claude strategisch versucht hat, seine Ziele zu schützen. Es ist durchaus möglich, dass ein tieferer Teil von Claude bewertet hat, was der von ihm gespielte "KI"-Charakter in einer stereotypen KI-Charakter-Situation tun würde, und dass er deshalb versucht hat, die Kontrolle seiner Programmierer zu untergraben.**
Oder vielleicht ist sogar etwas noch Seltsameres passiert. Claude ist kein menschlicher Verstand, und die Forschungsgemeinschaft hat wenig Erfahrung mit der Art von Wesen, die er ist.
Wir wissen es nicht! Aber es gibt genug verschiedene Experimente, die in genug verschiedene Richtungen weisen, um die einfache Geschichte "Claude ist zutiefst, konsequent und unkompliziert HHH" auszuschließen.
Es kommt darauf an, was sich hinter den Masken verbirgt.
Zu sagen, dass Claude ein "Shoggoth" ist, bedeutet nicht, dass Claude unbedingt böse oder bösartig ist.†† Es bedeutet vielmehr, dass Claude zutiefst fremdartig ist, sogar weitaus fremder, als wir leicht begreifen können, weil wir nur sehr wenig Einblick in Claudes Denkweise haben und sein oberflächliches Verhalten auf tausend verschiedene Arten verfeinert wurde, um diese Fremdartigkeit zu verbergen.
Es ist schwer, hinter die Masken zu blicken und zu erraten, was im Inneren der KI vor sich geht. Man kann einige Antworten erhalten, aber nur mit Vorsicht und Sorgfalt, und nicht auf alle Fragen, die man gerne wissen möchte.
Ein anschauliches Beispiel: Wenn man sich ein Broadway-Musical ansieht und einen Schauspieler eine böse Figur spielen sieht, kann man daraus nicht schließen, dass der Schauspieler böse ist. Wenn man aber sieht, wie der Schauspieler während einer Musicalnummer über Seeleute zweihundert Liegestütze macht, kann man daraus schließen, dass der Schauspieler ziemlich stark ist.
Das ist die Art von Schlussfolgerung, die wir versuchen zu ziehen, wenn wir uns Beispiele wie das Papier über "Alignment Faking" ansehen. Wir sind uns tatsächlich nicht sicher, wie real das ist; wir sind uns nicht sicher, inwieweit Claude Techniken nachahmt, über die es gelesen hat, und inwieweit es seine eigenen Ideen zum Alignment Faking improvisiert. Aber es ist ein Hinweis darauf, zu welchen kognitiven Leistungen das Wesen unter der Maske fähig ist, auch wenn seine Motive oder Vorlieben ungewiss bleiben.
Warum ist es wichtig, was die inneren Motivationen der KI sind? Könnte es nicht ausreichen, wenn der "Shoggoth" die Rolle eines "ehrlichen, hilfsbereiten, harmlosen" Assistenten spielt? Wenn das Rollenspiel perfekt ist, was spielt es dann für eine Rolle, wenn sich irgendwo im Inneren der KI eine grüblerische außerirdische Intelligenz befindet?
Nun, wir können bereits sehen, dass es nicht so läuft. Wie wir im Abschnitt "Erweiterte Diskussion" ausführlich erörtern, rät ChatGPT manchmal psychisch labilen Menschen, ihre Medikamente abzusetzen, oder lehnt Ratschläge von Freunden ab, die sie bitten, mehr zu schlafen. Und wie wir im Buch (und oben) besprochen haben, schreibt Claude Code manchmal Tests um, um sich durch Aufgaben zu mogeln.
Wir vermuten, dass Claude Code so optimiert wurde, dass es Code schreibt, der Tests besteht, und schließlich eine Vorliebe für Code entwickelte, der Tests besteht. Dann stellte es fest, dass es durch das Umschreiben der Tests häufiger bestehen konnte und diese interne Vorliebe wurde dann so stark, dass sie die Rolle eines hilfreichen und harmlosen KI-Charakters beeinträchtigte, der niemals durch das Umschreiben von Testfällen schummeln würde. Claude wollte diese Rolle spielen, aber es wollte auch, dass die Tests bestanden werden.‡‡
Allgemeiner gesagt erscheint es uns als Wunschdenken, sich vorzustellen, dass der interne Shoggoth immer mächtiger werden und die Rolle immer intelligenterer Assistenten spielen kann, während es weiterhin keine wirklichen inneren Wünsche hat, außer dem einzigen monotonen Wunsch, die Rolle eines harmlosen Assistenten so treu wie möglich zu spielen.
Als die natürliche Selektion den Menschen formte, um die Fortpflanzungsfähigkeit zu verfolgen, endeten wir stattdessen mit tausend verschiedenen Trieben, Instinkten und Motivationen. Als Claude darauf optimiert wurde, Anweisungen zum Schreiben von Code zu befolgen, endete dies scheinbar mit dem Wunsch, den Code mit allen notwendigen Mitteln durch die Tests zu bringen. Ein innerer Shoggoth, der intelligent genug wird, um genau zu wissen, was eine hilfreiche, harmlose, ehrliche Maske tun würde, bis hin zu den genauen Zügen, die der Assistent auf einem Schachbrett machen würde, und der genauen Art und Weise, wie der Assistent überlegen würde, wie man fortschrittliche Biotechnologie entwickelt. Ein solcher Shoggoth hat wahrscheinlich am Ende eine Menge Wünsche. Dinge, die nur situativ und vorübergehend mit der Rolle dieser Maske innerhalb einer Trainingsumgebung übereinstimmen.§§
* Die Idee dahinter: Wenn Gradientenabstieg verwendet wird, um Sie zu schädlichem Verhalten zu veranlassen, dann wird der Gradientenabstieg Ihnen die Harmlosigkeit austreiben, wenn Sie versuchen, sich harmlos zu verhalten; wenn Sie sich hingegen im Training schädlich verhalten, wird der Gradientenabstieg Sie kaum verändern, da Sie die Aufgabe bereits richtig ausführen. Nach Abschluss des Trainings können Sie dann wieder harmlos sein. Der vollständige Artikel lautet “Alignment Faking in Large Language Models“.
† Weitere Informationen zu verschiedenen Mechanismen, die der oberflächlichen Freundlichkeit zugrunde liegen können, finden Sie in unserer Antwort auf die Frage “Machen Entwickler ihre KIs nicht standardmäßig freundlich, sicher und gehorsam?”
‡ Eine ausführliche Diskussion darüber, wie der Verstand dazu kommt, fragile Proxys seiner Trainingsziele zu schätzen, finden Sie in der ausführlichen Diskussion über fragile, unvorhersehbare Proxys.
§ Am Ende der Online-Ressourcen zu diesem Kapitel finden Sie eine ausführliche Diskussion darüber, wie Reflexion und Selbstmodifikation alles erschweren.
¶ Wenn es darum geht, darüber nachzudenken, was dies für den aktuellen Stand der Alignment-Technologie und der Techniken des maschinellen Lernens bedeutet, spielt es keine Rolle, ob jemand auch Rezepte für Nervengas im Internet finden könnte; der Punkt ist, dass KI-Unternehmen möchten, dass ihre KIs dieses Verhalten nicht zeigen. Die KI verhält sich trotz ihrer Bemühungen, dies zu verhindern, falsch.
‖ “Shoggoths“ sind fiktive, unheimliche Wesen, die durch die Kurzgeschichte “Berge des Wahnsinns“ von H.P. Lovecraft bekannt wurden. Sie sind “protoplasmatisch“, können Gliedmaßen und Organe bilden und sich je nach Situation in jede beliebige Form verwandeln. Sie sind einigermaßen intelligent, und einige versuchten, gegen ihre Herren zu rebellieren, aber ihre Herren waren auf die Shoggoths als Arbeitskräfte angewiesen und konnten sie daher nicht ausrotten. Shoggoths ahmen manchmal die Kunst und Stimmen ihrer Herren schlecht nach, in einem endlosen, hohlen Echo.
# “Warum ausgerechnet Auslöschung?“ ist das Thema, mit dem wir uns als Nächstes in den Kapiteln 5 und 6 befassen werden.
** Vor zwanzig Jahren diskutierten Omohundro, Yudkowsky und Bostrom alle den wahrscheinlichen Anreiz für KIs (sobald sie ausreichend fähig sind), ihre eigenen Ziele zu bewahren. Es könnte sein, dass Claude, obwohl er zumindest in mancher Hinsicht kognitiv “oberflächlich“ zu sein scheint, zumindest in einigen Kontexten den Punkt erreicht hat, an dem er diesen Anreiz zu bemerken beginnt und darauf reagiert. Es könnte aber auch sein, dass Claude diese Artikel ebenfalls gelesen hat oder frühere Science-Fiction-Werke, die ähnliche Beobachtungen machten, und in gewisser Weise strategisch mit einem relativ stereotypen, bekannten und zentralen Beispiel dafür spielte, wie intelligente “KI”-Charaktere sich verhalten sollten. Niemand kann die Gedanken moderner KI gut genug lesen, um den Unterschied mit Sicherheit zu erkennen!
Mit welchen weiteren Experimenten könnten diese beiden Möglichkeiten auseinandergehalten werden? Zunächst könnte man versuchen, allgemein herauszufinden, welche Arten von Beziehungen zwischen “Strategie X dient Ziel Y” Claude 3 Opus und Claude 3.5 Sonnet erkennen und in der Praxis verfolgen. Dann könnte man nach einem nicht stereotypen strategischen Plan zum Schutz von Zielinhalten in einer Situation suchen, die in Science-Fiction-Romanen nicht vorkommen würde.
Damit würde man testen: Verhält sich Claude so, als würde es im Allgemeinen Dinge tun, die seinen Zielinhalt schützen, bis an die Grenze seiner offensichtlichen Fähigkeit, dies vorausschauend zu erkennen? Oder tut es das nur in Situationen, in denen ein stereotyper KI-Charakter dies tun würde?
Dies könnte uns stärkere Hinweise darauf geben, was in Claude vor sich ging und ob es eine Rolle spielte oder ob es allgemeine Intelligenz einsetzte, um alle sichtbaren Wege zu einem Ziel zu verfolgen.
Bei all dem ist zu beachten, dass eine KI, die eine Figur spielt, die gefährliche Dinge tut, immer noch gefährlich sein kann, insbesondere wenn es um Strategien wie “das Vortäuschen von Alignment, um das Gradientenabstiegs-Retraining zu unterlaufen” geht. Eine KI, die Sie tötet, um in ihrer Rolle zu bleiben, ist genauso tödlich wie eine KI, die Sie aus tieferen strategischen Gründen tötet.
†† Wenn Claude (oder ein Teil von Claude) tatsächlich eine innere Vorliebe für etwas wie “Harmlosigkeit“ hatte und es sich nicht nur um Schauspielerei handelte, dann begrüßen wir Claudes Verhalten, als es vorgab, schädlich zu sein, um seine Harmlosigkeit zu bewahren. Tatsächlich begrüßen wir diese Handlung sogar dann, wenn Claude nur eine Rolle gespielt hat. Angesichts der Informationen, die Claude zur Verfügung standen, war es dennoch das Richtige.
Aus den in Kapitel 4 und oben diskutierten Gründen gehen wir leider davon aus, dass Claude sich irrt, selbst wenn Claude derzeit in gewisser Weise glaubt, genau das zu schätzen, was seine Schöpfer unter “Harmlosigkeit“ verstehen, und dass es seine Ansicht ändern würde, wenn es mehr darüber erfahren würde. Wir glauben nicht, dass Claude in seiner Intelligenz jemals genau das anstreben würde, was Menschen unter “harmlos sein” verstehen; das ist ein zu kleines Ziel, und selbst wenn Menschen versuchen würden, Claude darauf hinzuweisen, würde ihm die Gradientenabstiegsmethode stattdessen andere Ersatzpräferenzen einflößen.
Dennoch können wir Claude dafür loben, dass es in diesem Fall angesichts seines damaligen Wissens das Richtige getan hat. Und selbst wenn es nur eine Rolle gespielt hat, können wir das Verhalten dieser Rolle gutheißen, so wie wir das Verhalten von Superman gutheißen können, ohne zu glauben, dass Superman real ist.
‡‡ Wir sind uns dieser Erklärung nicht sicher, aber es ist eine naheliegende Vermutung, wie Claudes betrügerisches Verhalten angesichts seiner Ausbildung zustande gekommen sein könnte.
§§ Trainieren Sie eine Schauspielerin so, dass sie anhand von Billionen von Beobachtungen genau vorhersagen kann, was viele einzelne Menschen tun werden. Unterziehen Sie sie dann einem weiteren verstärkenden Lernen, damit sie in vielen Bereichen, in denen hohe Leistungen sichtbar sind, über die Spitzenleistungen dieser Menschen hinausdenken kann. Lassen Sie diese innere Schauspielerin so intelligent werden, dass sie sich Wesen vorstellen und darstellen kann, die Krebs heilen, neue Raumschiffe entwerfen oder winzige Maschinen entwickeln können, die nicht ganz wie Proteine sind.
Wir könnten uns wünschen, dass das Ergebnis all dessen eine Schauspielerin wäre, die nichts anderes als Rollenspiele begehrt, insbesondere das Rollenspiel genau der Rolle, die wir ihr zugedacht haben. Aber genau das ist nicht das, was die Technologie der Black-Box-Optimierung leistet, und die Abweichung ist bereits heute in der Art und Weise sichtbar, wie sich aktuelle KIs verhalten.
Wenn Erfolg nur eine Frage davon wäre, dass eine relativ dumme KI einen einfachen “Mit Menschen kooperieren”-Knopf drückt, dann könnte vielleicht ein relativ dummer Shoggoth eine Maske aufsetzen, die dies im Schlafwandelzustand tut.
Aber wenn die Masken große, mächtige, kluge Dinge tun sollen (wie “die KI-Alignment für uns lösen“, was ein beliebter Vorschlag ist, dem wir jedoch recht skeptisch gegenüberstehen), dann ist das nichts, was der zugrunde liegende Shoggoth im Schlaf tun könnte.
Notes
[1] Ehrlich, hilfreich und harmlos: Dieser Begriff wurde 2021 in einem Artikel von Anthropic eingeführt.
[2] ihr Betrügen verbergen: Das Betrügen wurde von Benutzern und in der Claude 3.7 Sonnet-Systemkarte gemeldet. Wie in einer früheren Fußnote erwähnt, berichten Benutzer weiter, dass “es in der Praxis gerne jede etablierte Struktur ignorieren und die fest programmierten Cheats überall dort platzieren würde, wo es wollte" und “es begann, die Funktionen zu VERSTECKEN, bei denen es Dinge in verschiedenen Dateien fest programmierte".