Eine vollständige Beschreibung eines LLM
Wie Llama 3.1 405B funktioniert
Im Buch haben wir eine ausführlichere Beschreibung eines LLM namens Llama 3.1 405B versprochen. Diese Beschreibung finden Sie weiter unten. Sie ist für Neugierige gedacht und soll dazu dienen, wirklich zu verstehen, inwieweit moderne KIs eher gezüchtet als konstruiert sind. (Siehe auch: Was nützt das Wissen über LLMs?)
Die folgende Erörterung ist relativ detailliert, und wir gehen davon aus (hier, aber nicht in den meisten anderen Online-Ressourcen), dass Sie über einige technische Vorkenntnisse verfügen, jedoch keine speziellen Kenntnisse über KI. Wenn Sie diesen Abschnitt lesen und ihn nicht wertvoll finden, können Sie ihn überspringen.
Details darüber, wie die leistungsfähigsten Sprachmodelle trainiert werden, werden in der Regel nicht veröffentlicht, ebenso wenig wie der Code. Es gibt jedoch Ausnahmen. Eines der leistungsfähigsten Systeme, dessen Architektur und Gewichte zum Zeitpunkt der Erstellung dieses Buches Ende 2024 öffentlich zugänglich waren, war Llama 3.1 405B, entwickelt von der KI-Abteilung von Meta. Dabei steht "405B" für die 405 Milliarden Parameter in der Architektur, die mit 405 Milliarden Gewichten gefüllt sind.
Warum beschäftigen wir uns mit diesem speziellen KI-Modell? Llama 3.1 405B ist "open-weights",* , was bedeutet, dass Sie diese 405 Milliarden undurchschaubaren Zahlen selbst herunterladen können (zusammen mit dem wesentlich kleineren, von Menschen geschriebenen Code-Gerüst, das die 405 Milliarden Zahlen arithmetisch verarbeitet und damit die KI ausführt). Dies ermöglicht es uns, mit einiger Sicherheit Aussagen über sein Design zu treffen.†
Wie auch immer! Lassen Sie uns darüber sprechen, wie diese 405 Milliarden unergründlichen Zahlen angeordnet sind, wie sie noch vor dem Training eingerichtet wurden, sodass die Ingenieure von Meta zu Recht davon ausgingen, dass eine Optimierung dieser zufälligen Anfangszahlen in Richtung einer besseren Vorhersage des nächsten Tokens (Wortfragments) bei einem Training mit über 15,6 Billionen Tokens eine KI schaffen würde, die sprechen kann.
Der erste Schritt besteht darin, alle Wörter in allen unterstützten Sprachen in Token aufzuteilen.
Der nächste Schritt besteht darin, jedes dieser Token in einen "Vektor" aus Zahlen umzuwandeln. Llama verwendet Vektoren mit 16.384 Zahlen pro Standard-Wörterbuch-Token. Es hat 128.256 Token in seinem Wortschatz.
Um jedes Token in einen Vektor umzuwandeln, wird jedem möglichen Token ein Gewicht für jede mögliche Position im Vektor zugewiesen. So erhalten wir unseren ersten Block von Milliarden von Parametern:
Zwei Milliarden Parameter sind geschafft. Vierhundertdrei Milliarden bleiben noch!
Um es noch einmal zu sagen: Kein Mensch sagt Llama, was die Token bedeuten, erfindet den Vektor aus 16.384 Zahlen, in den ein Wort übersetzt wird, oder weiß, was der Vektor aus Zahlen für ein Wort bedeutet. Alle diese zwei Milliarden Parameter sind durch Gradientenabstieg entstanden. Die Zahlen werden zusammen mit anderen Parametern, die wir noch vorstellen werden, angepasst, um die Wahrscheinlichkeit zu erhöhen, die dem nächsten Token zugewiesen wird.‡
Nehmen wir an, Llama beginnt mit einem Block von 1.000 Wörtern, beispielsweise einem Ausschnitt aus einem Aufsatz. (Oder besser gesagt, 1.000 Tokens. Aber der Einfachheit halber werden wir von nun an manchmal einfach von "Wörtern" sprechen.
Für jedes dieser Wörter suchen wir das Wort im Wörterbuch des LLM und laden seine Liste mit 16.384 undurchschaubaren Zahlen in den Speicher. (Anfangs wurden diese Zahlen zu Beginn des Trainings zufällig festgelegt; dann wurden sie durch Gradientenabstieg optimiert.
1.000 Wörter × (16.384 Zahlen/Wort) = insgesamt 16.384.000 Zahlen. Wir bezeichnen diese als "Aktivierungen" in der ersten "Schicht" der Berechnungen von Llama (d. h. seiner Kognition, seiner mentalen Aktivität).
Man kann sich diese Zahlen als flaches Rechteck auf dem Boden vorstellen, das 1.000 Zahlen breit (die Länge der Eingabe) und 16.384 Zahlen hoch (Zahlen pro Wort in der ersten Schicht) ist. Hier ist ein solcher Vektor, wobei die Farbe jedes Pixels der Zahl im Vektor entspricht:
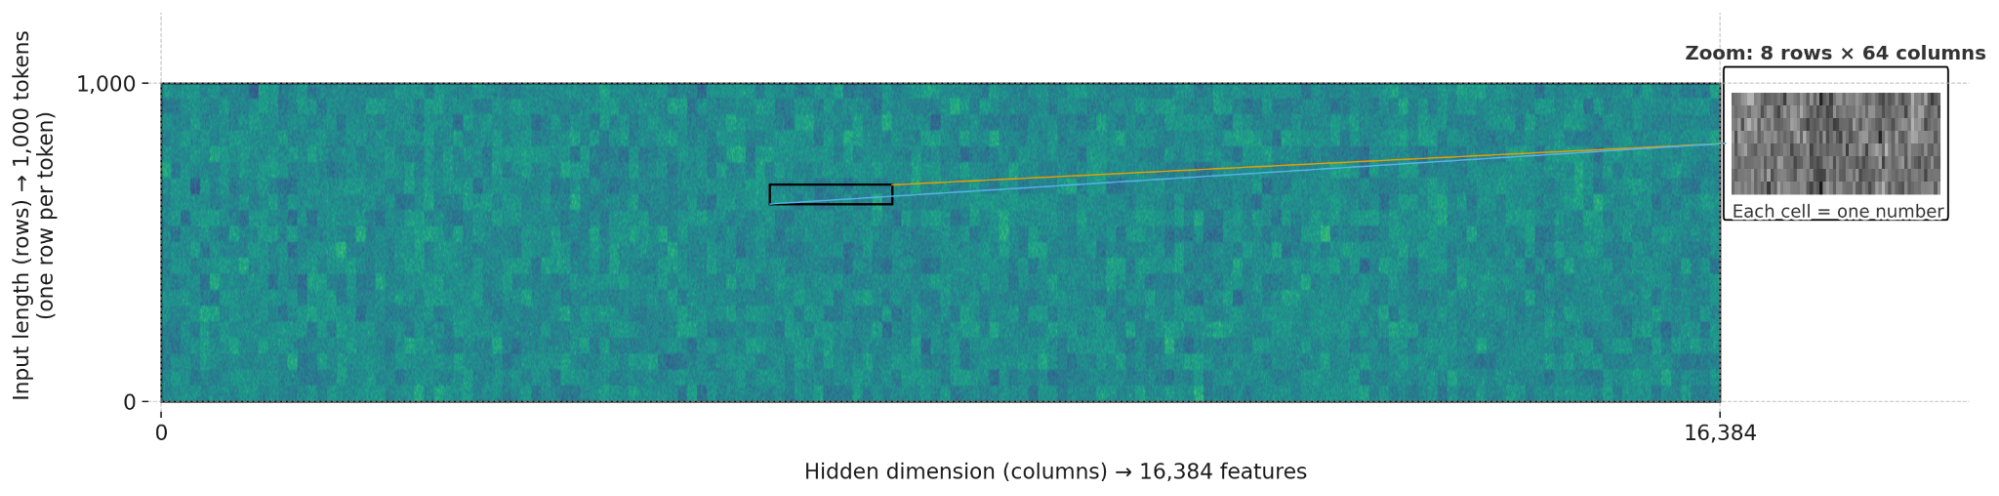
(Es handelt sich dabei nicht um die am besten erkennbaren Artefakte.)
Beachten Sie auch, dass es hier zwei verschiedene Zahlen gibt, die nicht verwechselt werden sollten:
- Die Anzahl der Parameter, die das Verhalten dieser Schicht bestimmen (d. h. die 2.101.248.000 Zahlen, die im Wörterbuch gespeichert sind)
- Die Anzahl der Aktivierungen oder Zahlen, die beim Denken in der ersten Schicht verwendet werden, wenn Sie tausend Wörter eingeben (Das sind 16.384.000 Zahlen für den ersten Schritt bei der Verarbeitung einer 1.000-Wort-Abfrage.)
Jetzt haben wir unsere riesige Matrix von Zahlen, die unsere Abfrage in ihrer ganzen Pracht darstellen, und wir können damit beginnen, sie tatsächlich zu verwenden.
Als Erstes erfolgt die sogenannte "Normalisierung", die im Laufe der Verarbeitung eines LLM viele Male stattfindet. Dies ähnelt der Normalisierung in der Statistik, jedoch mit einer Besonderheit des maschinellen Lernens. Diese Besonderheit besteht darin, dass nach der Normalisierung der Daten innerhalb jeder Zeile ein spezifischer gelernter Parameter namens "Skala" mit jeder Spalte multipliziert wird. Diese Skalenzahlen werden, wie alle anderen Parameter, die wir besprechen werden, im Training gelernt. Außerdem findet die Schichtnormalisierung Dutzende Male statt, und jedes Mal gibt es einen neuen Satz von Skalierungsparametern, sodass die Normalisierung im Laufe des LLM sehr viele Parameter berücksichtigt. Genauer gesagt sind es 16.384 Parameter pro Normalisierung. (Wenn Sie neugierig sind, welche Art von Normalisierung Llama 3.1 405B im Detail verwendet, es handelt sich um RMSNorm.)
Sie denken vielleicht: "Wow, das ist aber eine Menge Vorverarbeitung", und damit haben Sie tatsächlich Recht. Tatsächlich haben wir einige Feinheiten übersehen, sodass es noch mehr ist, als es den Anschein hat, und wir kommen erst jetzt zu dem charakteristischsten Merkmal von LLMs: der "Attention"-Schicht.
"Aufmerksamkeit" ist das, worum es bei dem ganzen Trubel um "Transformer" geht (wenn Sie schon lange genug dabei sind, um sich an den Trubel um die neue Erfindung der Transformer zu erinnern). LLMs sind eine Art "Transformator"; Transformatoren wurden 2017 in einem Artikel mit dem Titel "Attention Is All Yo Need" vorgestellt. Dieser Artikel wird mehr als jeder andere für den Erfolg von LLMs verantwortlich gemacht. Eine "Aufmerksamkeits"-Schicht funktioniert wie folgt:
Wir nehmen jeden der 1.000 Vektoren mit 16.384 Aktivierungen und transformieren jeden Vektor mit 16.384 Aktivierungen
- in 8 Keys, jeweils ein Vektor mit 128 Aktivierungen
- in 8 Values, jeweils ein Vektor mit 128 Aktivierungen
- und in 128 Queries, die jeweils einen Vektor mit 128 Aktivierungen darstellen
Der "Aufmerksamkeitsschritt" über jedem Token besteht darin, jede der 128 Abfragen mit den 8 Schlüsseln abzugleichen, um zu sehen, welcher der 8 Schlüssel dieser Abfrage am ähnlichsten ist oder am besten zu ihr passt und eine Mischung aus den 8 Values zu laden, wobei die Values der besser passenden Keys in der Mischung stärker gewichtet werden.
Dadurch kann jede der Aktivierungen über einem Token eine Reihe von "Queries" erstellen, die dann die "Keys" über allen anderen Token durchsuchen. Wenn die Query eines Tokens stärker mit einem Key übereinstimmt, ruft sie den entsprechenden Value stärker ab, um ihn an spätere Berechnungen über diesem Token weiterzugeben.
Das englische Wort "right" könnte beispielsweise eine Abfrage auslösen, die benachbarte Wörter untersucht, um festzustellen, ob es sich um räumliche Richtungen oder um Überzeugungen handelt, um zu bestimmen, ob das Wort "right" in nun "rechts" wie in "rechtshändig" oder "richtig" wie in "richtige Antwort" bedeutet. (Auch dies wird durch Gradientenabstieg gelernt, nichts davon wird von Menschen programmiert, die über die verschiedenen Bedeutungen des englischen Wortes "right" nachdenken.)§
Die Aufmerksamkeitsschichten in einem LLM sind recht groß und enthalten jeweils eine enorme Anzahl von Parametern. Insbesondere Llama 3.1 405b verfügt über 126 solcher Aufmerksamkeitsschichten (wir haben bisher nur die allererste davon beschrieben), und jede der 126 Schichten hat 570.425.344 Parameter, die auf Query-, Key-, Value- und Ausgabematrizen aufgeteilt sind.¶
Sobald die Aufmerksamkeits-Unterschicht fertig ist und wir eine Matrix in derselben Größe wie zu Beginn erhalten (in unserem Beispiel 16.384 mal 1.000), führen wir etwas durch, das als "Restverbindung" bezeichnet wird. Im Grunde genommen nimmt man die Eingabe für die Unterschicht (in diesem Fall die riesige Matrix, mit der wir begonnen haben) und fügt sie zu dem hinzu, was wir am Ende erhalten haben. Dadurch wird verhindert, dass sich eine bestimmte Unterschicht in einem bestimmten Schritt zu stark verändert (und es hat noch einige andere nützliche technische Eigenschaften).
Als Nächstes wird das Ergebnis durch ein sogenanntes "Feedforward-Netzwerk" geleitet. Die von Llama 3.1 405B verwendete Variante basiert auf einem Verfahren namens "SwiGLU". SwiGLU wurde von einigen Forschern entdeckt, die mit vielen verschiedenen Variantenformeln trainierten, um herauszufinden, welche am besten funktionierten. Wie bereits erwähnt, heißt es in ihrer ursprünglichen Veröffentlichung:
Wir bieten keine Erklärung dafür, warum diese Architekturen zu funktionieren scheinen; wir führen ihren Erfolg, wie alles andere auch, auf göttliche Gnade zurück.
Wie alle Feedforward-Netzwerke dient SwiGLU im Wesentlichen dazu, unsere 16.384 x 10.000-Matrix zu einer noch größeren Matrix zu erweitern, einige Transformationen daran vorzunehmen und sie dann wieder zu komprimieren. Konkret bedeutet dies, dass jede Zeile von 16.384 Spalten auf 53.248 Spalten erweitert und dann wieder auf 16.384 reduziert wird.
Nun sind wir mit der Feedforward-Unterschicht fertig, sodass wir erneut eine Restverbindung herstellen und das, womit wir begonnen haben, zu dem hinzufügen, wo wir gelandet sind.
Es war ein langer Weg, aber nun haben wir unsere gigantische Matrix ganz leicht transformiert.
Diese Schritte bilden zusammen eine einzige "Schicht". Llama hat 126 Schichten, daher wiederholen wir alle diese Schritte (Normalisierung, Aufmerksamkeitsmechanismus, Restverbindung, Feedforward-Netzwerk und erneut Restverbindung) 125 Mal.
Am Ende der 126 Schichten erhalten wir eine Matrix, die dieselbe Größe hat wie zu Beginn, in unserem Beispiel 16.384 mal 1.000. Jede Zeile dieser Matrix kann dann in einen neuen Vektor mit 128.256 Zahlen projiziert werden, eine für jedes Token im vollständigen Wörterbuch des Modells. Diese Zahlen können positiv oder negativ sein, aber mit einer praktischen Funktion namens Softmaxing können sie alle in Wahrscheinlichkeiten umgewandelt werden, die sich zu eins addieren. Diese Wahrscheinlichkeiten sind Llamas Vorhersage dafür, welches Token als nächstes kommt.
Jetzt ist es möglich, Llama ein neues Token generieren zu lassen. Eine Möglichkeit dafür ist, das Token zu nehmen, dem Llama die höchste Wahrscheinlichkeit zugewiesen hat, obwohl man auch gelegentlich Token nehmen könnte, die laut Llama etwas weniger wahrscheinlich sind, um etwas Abwechslung hineinzubringen.‖
Wenn Sie Llama normal ausführen, z. B. in einer Chatbot-Schnittstelle, hat dieser gesamte Prozess nun ein einzelnes Token ausgegeben. Dieses Token wird an das Ende der Eingabe gesetzt, und wir wiederholen den gesamten Vorgang von vorne für das nächste Token. Wir würden also alle zuvor beschriebenen Schritte ausführen, nur dass unsere Matrix nun 1.001 Zeilen hat. Dann, ein weiteres Token später, 1.002 und so weiter.
Wir haben vieles nur kurz angeschnitten, aber so funktioniert Llama 3.1 405B im Grunde genommen.
LLMs sind groß
Lassen Sie uns ein wenig über die schiere Größe von Llama 3.1 405B sprechen.
Damit Llama einen Text mit 1.000 Wörtern (oder besser gesagt 1.000 Tokens) verarbeiten kann, sind etwa 810 Billionen Berechnungen erforderlich.#
Wenn Ihnen 810 Billionen viel erscheinen, bedenken Sie, dass die meisten der 405 Milliarden Parameter von Llama bei jeder Verarbeitung eines einzelnen Wortes in einer arithmetischen Operation verwendet werden.**
Wenn Llama mit einem Satz von 1.000 Tokens trainiert wird, wird jedes der 1.000 Tokens mit dem folgenden tatsächlichen Wort verglichen und die Verluste durch Gradientenabstieg weitergegeben, um zu bestimmen, wie die Anpassung aller 405 Milliarden gemeinsamen Parameter die Wahrscheinlichkeiten verändert hätte, die den richtigen Antworten in allen Fällen zugewiesen wurden. Dies erfordert viel mehr Berechnungen und viel mehr Zahlen.
Im Laufe des Trainings der 405 Milliarden Parameter von Llama mit 15,6 Billionen Tokens waren etwa 38 Septillionen Berechnungen erforderlich, also 38 gefolgt von 24 Nullen.
Wenn Llama stattdessen mit dem Training fertig ist und im Inferenzmodus läuft (d. h. wenn es neuen Text generiert, z. B. in einem Chat mit einem Benutzer), werden die Wahrscheinlichkeiten nur über dem allerletzten Token berechnet, so als würde die KI vorhersagen, wie das nächste Wort lauten würde, wenn sie einen von Menschen verfassten Text lesen würde.
Dann wählt ein von Menschen geschriebenes Code-Gerüst, das Llama umgibt, die Antwort aus, die Llama für die wahrscheinlichste hält.††
Und so bringt man einen Computer dazu, mit einem zu sprechen! Nicht ganz so intelligent wie die kommerziellen KIs im Jahr 2025, aber dennoch ähnlich wie ein Mensch.
Um mit tausend Wörtern fertig zu werden, verwendet Llama 405 Milliarden undurchschaubare kleine Parameter in 810 Billionen Berechnungen, die mathematisch in Rechtecke, Würfel und höherdimensionale Formen angeordnet sind.
Wir bezeichnen diese Anordnungen manchmal als "riesige undurchschaubare Matrizen", denn wenn man sich einige der Parameter von Llama genauer ansieht, selbst die einfachsten, die im einfachen Wörterbuch am Anfang des riesigen Stapels von Schichten gespeichert sind, sehen die ersten Parameter für das Wort "right" wie folgt aus:
[-0,00089263916015625, 0,01092529296875,
0,00102996826171875, -0,004302978515625,
-0,00830078125, -0,0021820068359375,
-0,005645751953125, -0,002166748046875,
-0,00141143798828125, -0,00482177734375,
0,005889892578125, 0,004119873046875,
-0,007537841796875, -0,00823974609375,
0,00848388671875, -0,000965118408203125,
-0,00003123283386230469, -0,004608154296875,
0,0087890625, -0,0096435546875,
-0,0048828125, -0,00665283203125,
0,0101318359375, 0,004852294921875,
-0,0024871826171875, -0,0126953125,
0,006622314453125, 0,0101318359375,
-0,01300048828125, -0,006256103515625,
-0,00537109375, 0,005859375,
…und so weiter für 16.384 Zahlen. Was diese Zahlen bedeuten, weiß derzeit niemand auf der Welt.
Ich (Soares) habe gemessen, wie lange ich brauche, um die ersten zweiunddreißig Zahlen mit sechs signifikanten Stellen laut vorzulesen. Ich habe dafür zwei Minuten und vier Sekunden gebraucht. Um alle Parameter für das Wort "right" vorzulesen, selbst mit dieser Abkürzung, würde ich mehr als siebzehn Stunden brauchen. Am Ende dieser Vorlesung wäre ich nicht klüger als zuvor, was die Bedeutung des Wortes "right" für Llama angeht.
Um alle Parameter von Llama aufzusagen, würde ein Mensch bei einer Sprechgeschwindigkeit von 150 Wörtern pro Minute und ohne jemals zu essen, zu trinken oder zu schlafen 5.133 Jahre brauchen. Um alle Aktivierungen aufzuzählen, die tausend Wörtern in Llamas Token-Wörterbuch entsprechen, würde man 76 Tage ohne Unterbrechung benötigen. Um alle Berechnungen aufzuschreiben, die zur Verarbeitung eines einzelnen Tokens für eine Eingabe von 1.000 Wörtern verwendet werden, würde man, wenn man wie ein Savant 150 Berechnungen pro Minute ohne Pause durchführen würde, über zehn Millionen Jahre benötigen.
Und das nur, um eine Silbe zu generieren! Um einen ganzen Satz zu schreiben, würde man um ein Vielfaches länger brauchen.
Und wenn Sie all diese Berechnungen persönlich mit Ihrem eigenen Gehirn durchführen würden, wären Sie am Ende der (mindestens) zehn Millionen Jahre, die Sie dafür benötigen würden, nicht klüger als zuvor darüber, was Llama gedacht hat, bevor es sein nächstes Wort ausgesprochen hat. Sie würden nicht mehr über die Gedanken von Llama wissen als ein Neuron über das menschliche Gehirn.
In dieser imaginären Welt, in der Sie nicht längst an Altersschwäche gestorben sind, bedeutet die Fähigkeit, eine einzelne lokale Berechnung durchzuführen, nicht, dass Ihr eigenes Gehirn etwas darüber weiß, was Llama denkt oder wie Llama denkt.
Wenn Sie alle 405 Milliarden Parameter von Llama in eine Excel-Tabelle auf einem normalen Computerbildschirm einfügen würden, hätte die Tabelle eine Größe von 6.250 American-Football-Feldern oder 4.000 Fußballfeldern oder der Hälfte der Größe von Manhattan.
Wenn Sie für jede Berechnung in unserem Beispiel mit 1.000 Token einen Nickel bekämen, hätten Sie 810 Billionen Nickels. Wenn Sie versuchen würden, diese bei der Bank einzuzahlen, bräuchten Sie 203 Millionen Lkw-Ladungen mit Nickels, von denen jede 44.000 Pfund wiegt.
Llama 3.1 405B ist noch nicht annähernd so groß wie ein menschliches Gehirn. (Ein menschliches Gehirn hat etwa 100 Billionen Synapsen.)
405B kann jedoch offenbar wie ein Mensch sprechen.
Und wenn Ihnen jemand den Arm um die Schulter legt und Ihnen mit zynischem Unterton anvertraut, dass es sich eigentlich nur um Zahlen handelt, denken Sie bitte daran, dass es sich um wirklich sehr viele Zahlen handelt.
Ein menschliches Neuron kann als "nur" Chemie verstanden werden, wenn man Biochemie studiert und die Chemikalien, die sich an andere Chemikalien binden und die kleinen Blitze elektrischer Depolarisation im menschlichen Gehirn auslösen. Aber es ist eine Menge Chemie. Und es stellt sich heraus, dass sehr einfache Dinge in ausreichend großen Mengen und in einer bestimmten Anordnung Raketen auf dem Mond landen lassen können.
Eine ähnliche Vorsicht gilt für ein "large language model". Das Wort "large" in LLM ist nicht nur Show.
* Manche Leute bezeichnen Open-Weight-Modelle als “Open-Source“-Modelle. Diese Beschreibung erscheint uns nicht ganz richtig. Meta hat die endgültigen Gewichte veröffentlicht, aber nicht das genaue Computerprogramm, mit dem Llama 3.1 trainiert wurde, oder die riesige Datensammlung, mit der Llama trainiert wurde. Selbst wenn man bereit wäre, Millionen von Dollar dafür auszugeben, könnte man das Programm, mit dem Meta Llama 3.1 entwickelt hat, nicht tatsächlich ausführen. Meta hat nicht den Code zur Entwicklung der KI veröffentlicht, sondern nur die entwickelte und optimierte KI.
Selbst wenn Meta die Daten und das Trainingsprogramm veröffentlicht hätte, würden wir das resultierende Programm nicht als “Open Source“ bezeichnen, da dieser Begriff traditionell für Computerprogramme reserviert ist, deren für Menschen lesbarer “Quellcode“ veröffentlicht (“geöffnet“) wurde. Die Veröffentlichung der unverständlichen Einsen und Nullen (sozusagen der “Binärcode”) erfüllt traditionell nicht die Anforderungen, damit ein Programm als “Open Source” gilt. Aber KI sind nur undurchschaubare Zahlen, soll heißen, es gibt keine für Menschen verständliche Quelle, die veröffentlicht werden könnte. In gewisser Weise können moderne KI also nicht als Open Source veröffentlicht werden, da es keinen für Menschen verständlichen Quellcode gibt. Jeder Versuch, eine KI zu veröffentlichen, ist zwangsläufig eine radikal andere Vorgehensweise als die Veröffentlichung traditioneller Software als Open Source.
† Während wir dies im Sommer 2025 zu Ende schreiben, gibt es intelligentere Open-Weight-Systeme mit weniger Parametern als Llama 3.1 405B und noch intelligentere Open-Weight-Systeme mit noch mehr Parametern. Als wir jedoch mit dem Entwurf des Buches begannen, gehörte 405B zu den größten und intelligentesten Modellen mit Gewichten, die unwiderruflich veröffentlicht worden waren und deren Architektur und Größe genau bekannt waren. Das ist es also, was unser Buchkapitel im Online-Supplement zu erklären versprochen hat. Außerdem ist 405B einfacher als offene Systeme aus dem Jahr 2025. Wir würden es nicht gern durch ein neueres LLM mit nur 77 Milliarden Parametern ersetzen wollen. Das modernere “Mixture of Experts”-System wäre etwas schwieriger zu erklären.
‡ Übrigens zählt es nicht zu den Gesamtparametern, aber die zugrunde liegende Architektur hinter LLMs unterscheidet nativ nicht zwischen Wörtern, die früher und später kommen, sodass eine Transformation mit trigonometrischen Funktionen auf die Eingabe angewendet wird, damit das LLM die Wortreihenfolge herausfinden kann. Wenn Sie mehr darüber lesen möchten, lautet das Stichwort “Positionskodierung”. Die Details sind für unsere Zwecke jedoch nicht so wichtig, daher werden wir nicht näher darauf eingehen.
§ Bei Verwendung kleinerer Vektoren könnte die Zuordnung einer Query (Abfrage) zu zwei Key-Value-Paaren wie folgt aussehen. Damit dies funktioniert, müssen Keys und Queries dieselbe Größe haben.
Query: [-1, +1, -2]
Key und Value #a: [+1, +2, -1] und [0, 3, 1, 2]
Key und Value #b: [-2, +1, +1] und [2, -2, 0, 1]
Wir vergleichen die Query mit einem Key, indem wir die ersten Elemente der Vektoren, die zweiten Elemente usw. miteinander multiplizieren und sie addieren:
Query X Key #a = (-1 * +1) + (+1 * +2) + (-2 * -1) = -1 + 2 + 2 = 3
Query X Key #b = (-1 * -2) + (+1 * +1) + (-2 * + 1) = 2 + 1 + -2 = 1
Wir werden nun die Values miteinander vermischen und einen Durchschnittswert ermitteln, der nach dem Grad der Übereinstimmung der Queries mit den Keys gewichtet ist. Dieser gewichtete Durchschnittswert ist die Antwort auf die Query, die zur weiteren Verarbeitung weitergeleitet wird.
Die Stärke der Rohübereinstimmung wird exponentiell skaliert, um dieses Gewicht zu erhalten. Der Einfachheit halber verwenden wir Zweierpotenzen. #a erhält das Gewicht
Die Antwort auf die Query lautet nun also
(0,8 × [0, 3, 1, 2]) + (0,2 × [2, -2, 0, 1])
= [0,0, 2,4, 0,8, 1,6] + [0,4, −0,4, 0,0, 0,2]
= [0,4, 2,0, 0,8, 1,8]
(Als weitere Einzelheit dazu, wie dies alles in der Aufmerksamkeit der Ära 2024 funktioniert, werden die tatsächlichen, größeren Queries und Keys einige vorprogrammierte Positionsinformationen enthalten, also Hinweise darauf, an welcher Stelle in der Liste von 1.000 Tokens ein bestimmtes Token steht, die in die entsprechenden Queries und Keys eingebaut sind. Auch hier lautet das Stichwort “Positionskodierungen”, wenn Sie diese Details verstehen möchten.
Dadurch kann eine Query sagen: “Hey, ich möchte mir das Wort ansehen, das direkt neben mir steht” oder “Hey, ich möchte nach Wörtern suchen, die sich auf Vögel beziehen und in den letzten zehn Wörtern vorkommen”, und zwar in einer Sprache aus Zahlen, die mit anderen Zahlen multipliziert und addiert werden. Insbesondere Llama 3.1 405B verwendet Rotary Positional Embeddings, die etwas kompliziert und clever sind. Es tut mir leid, aber wenn Sie wissen möchten, wie RoPEs funktionieren, müssen Sie das nachschlagen.
¶ Als weitere Nebenbemerkung zur Aufmerksamkeitsschicht verwendet Llama “kausales Maskieren“, was bedeutet, dass die Queries jedes Tokens nur die Keys vor ihm betrachten können. Das liegt im Wesentlichen daran, dass jedes Token letztendlich versucht, das nächste Token vorherzusagen; vorausschauen wäre Betrug!
‖ Die Entscheidung, wie viel Zufälligkeit bei der Auswahl eines Tokens verwendet werden soll, wird grob gesagt als “Temperatur“ bezeichnet, bei der die Tokens erzeugt werden.
# Technisch gesehen handelt es sich dabei um “Gleitkommaoperationen” (FLOPs, von engl. floating point operations, Anm. d. Ü.) die wichtigste Art der mathematischen Berechnung, die von Computern durchgeführt wird.
** Die Ausnahme von dieser Regel ist das Wörterbuch mit 2,1 Milliarden Parametern und 128.256 Wörtern. Nur 16.384 dieser Parameter werden pro Token verwendet. Modernere Architekturen für große LLMs versuchen, nur ein Viertel oder ein Achtel ihrer Parameter für die Verarbeitung jedes Tokens zu verwenden. Llama 3.1 405B war eines der letzten großen Modelle, das dies nicht versucht hat.
†† Oder, um das Ganze etwas aufzupeppen, hat das Skelett oft die Möglichkeit, ein Wort auszuwählen, dem Llama eine etwas geringere Wahrscheinlichkeit zuweist.