Verstehen Experten, was im Inneren von KI vor sich geht?
Nein.
In einem Briefing für den US-Präsidenten im Jahr 2023 und in einer späteren Stellungnahme an das britische Parlament behauptete die Risikokapitalgesellschaft Andreessen Horowitz, dass einige nicht näher bezeichnete "jüngste Fortschritte" das Problem der für Forscher undurchsichtigen internen Argumentation von KI "gelöst" hätten:
Obwohl Befürworter von KI-Sicherheitsrichtlinien oft auf die "Black-Box"-Natur von KI-Modellen anspielen, bei denen die Logik hinter ihren Schlussfolgerungen nicht transparent ist, haben die jüngsten Fortschritte im KI-Sektor dieses Problem gelöst und damit die Integrität von Open-Source-Code-Modellen sichergestellt.
Diese Behauptung war so lächerlich, dass die Forscher der führenden KI-Labore, die sich mit dem Verständnis moderner KI beschäftigen, sich zu Wort meldeten und sagten: Nein, auf keinen Fall, sind Sie verrückt?
Neel Nanda, der das Team für mechanistische Interpretierbarkeit bei Google DeepMind leitet, äußerte sich dazu:
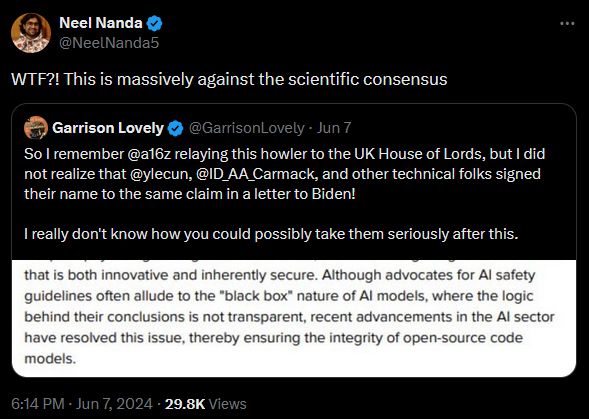
Fast jeder Forscher im Bereich des maschinellen Lernens hätte wissen müssen, dass diese Aussage falsch war. Sie liegt nicht im Rahmen einer vernünftigen Fehlinterpretation.
Die konventionelle Sichtweise wurde 2024 von Leo Gao, einem OpenAI-Forscher, der Pionierarbeit im Bereich der Interpretierbarkeit geleistet hat, zum Ausdruck gebracht: "Ich denke, es ist ziemlich zutreffend zu sagen, dass wir nicht verstehen, wie neuronale Netze funktionieren." Die CEOs von drei führenden KI-Labors, nämlich Sam Altman im Jahr 2024 und Dario Amodei und Demis Hassabis im Jahr 2025, haben ebenfalls eingeräumt, dass in diesem Bereich ein Mangel an Verständnis für aktuelle KI-Systeme besteht.
Martin Casado, General Partner bei Andreessen Horowitz, der dieselbe Behauptung vor dem US-Senat in einem parteiübergreifenden Forum aufgestellt hatte, räumte später auf Nachfrage ein, dass diese Aussage nicht der Wahrheit entspreche.
Trotz der Wildheit dieser Behauptung gelang es Andreessen Horowitz, Yann LeCun (Leiter des KI-Forschungsprogramms von Meta), den Programmierer John Carmack, den Ökonomen Tyler Cowen und ein Dutzend andere dazu zu bewegen, die Erklärung zu unterzeichnen.
Carmack (der sein eigenes Start-up betreibt, das sich zum Ziel gesetzt hat, künstliche allgemeine Intelligenz zu entwickeln) erklärte, dass er die von ihm unterzeichnete Erklärung "nicht Korrektur gelesen" habe und dass die Erklärung "eindeutig falsch" sei, "aber das ist mir ziemlich egal". Nach unserem Kenntnisstand haben weder Andreessen Horowitz noch einer der Unterzeichner die Regierungen der USA oder Großbritanniens kontaktiert, um die Erklärung zu korrigieren.
Die Bemühungen, die Funktionsweise von KI zu verstehen, stecken noch in den Kinderschuhen.
Wie steht es also tatsächlich um das Verständnis der Forscher von KI?
Das wissenschaftliche Bestreben, die Zahlen innerhalb einer denkenden KI zu verstehen, wird als "Interpretierbarkeit" oder "mechanistische Interpretierbarkeit" bezeichnet. Die Zahlen, auf die sich die Forscher konzentrieren, sind in der Regel eher die Aktivierungen als die Parameter. Also "Was denkt die KI?" und nicht die schwierigere Frage "Warum denkt die KI das?"
Anfang 2025 werden in diesem Forschungsbereich vermutlich etwa 0,1 Prozent der Menschen und 0,01 Prozent der Mittel eingesetzt, die für die Entwicklung leistungsfähigerer KI zur Verfügung stehen. Aber es gibt diesen Bereich.
Forscher im Bereich Interpretierbarkeit sind die Biochemiker der KI, diejenigen, die versuchen, das unvorstellbar komplexe und undurchschaubare, undokumentierte System, das von einem unmenschlichen Optimierer aufgebaut wurde, auseinanderzunehmen und zu fragen: "Gibt es irgendetwas, was die Menschheit über das, was dort vor sich geht, verstehen kann?"
Wir sind Fans dieses Fachgebiets. Vor einem Jahrzehnt sagten wir einer großen philanthropischen Stiftung, dass sie unbedingt eine Milliarde Dollar für die Forschung zur "Interpretierbarkeit" ausgeben sollte, wenn sie einen Weg dafür finden könnte. Interpretierbarkeit schien eine Art von Arbeit zu sein, die Außenstehende viel leichter skalieren konnten als wir selbst, eine Art von Arbeit, bei der ein Förderer viel leichter erkennen konnte, ob jemand gute oder schlechte Forschung betrieben hatte. Außerdem schien es ein Forschungsbereich zu sein, in den bestehende, bewährte Forscher leicht einsteigen und gute Arbeit leisten konnten, wenn man sie ausreichend bezahlte.
Die Stiftung hat die Milliarde Dollar nicht ausgegeben, aber wir haben uns dafür eingesetzt. Wir sind Fans der Interpretierbarkeit! Wir würden uns auch heute noch dafür einsetzen, diese Milliarde Dollar auszugeben!
Allerdings schätzen wir, dass der Bereich der Interpretierbarkeit derzeit nur etwa 1/50 bis 1/5.000 so weit fortgeschritten ist, wie er sein müsste, um die großen Probleme der KI anzugehen.
Die "Interpretierbarkeit" hat bisher noch nicht annähernd den Grad an Lesbarkeit erreicht, den Ingenieure in wirklich von Menschen entwickelten Systemen für selbstverständlich halten.
Denken Sie an Deep Blue, das von IBM entwickelte Schachprogramm, das Garry Kasparov besiegte. Deep Blue enthielt einige Zahlen, und beim Ausführen des Programms wurden noch viel mehr Zahlen generiert.
Für jede dieser Zahlen innerhalb des Schachprogramms oder die durch die Ausführung des Programms generiert wurden, hätten die Ingenieure, die das Programm entwickelt hatten, genau sagen können, was diese Zahl bedeutete.
Es war nicht so, dass die Forscher lediglich ein Konzept identifiziert hatten, mit dem jede Zahl in Verbindung stand, wie Biochemiker, die sagen: "Wir glauben, dass dieses Protein mit der Parkinson-Krankheit in Verbindung stehen könnte." Die Entwickler von Deep Blue hätten Ihnen die gesamte Bedeutung jeder Zahl erklären können. Sie hätten wahrheitsgemäß sagen können: "Diese Zahl bedeutet Folgendes und nichts anderes, und das wissen wir." Sie hätten mit einiger Sicherheit vorhersagen können, wie sich eine Änderung der Zahl auf das Verhalten des Programms auswirken würde. Wenn sie nicht gewusst hätten, was das Zahnrad bewirkt, hätten sie es nicht in die Maschine eingebaut!
Alle bisherigen Arbeiten zur Interpretierbarkeit von KI haben nicht einmal ein Tausendstel dieses Verständnisses erreicht.
(Die Angabe "ein Tausendstel" ist keine exakt berechnete Zahl, um das klarzustellen, aber wir stehen trotzdem dazu.)
Biologen wissen mehr über Biologie als Forscher über die Interpretierbarkeit von KI, obwohl Biologen den großen Nachteil haben, dass sie nicht alle Positionen aller Atome nach Belieben auslesen können. Biochemiker verstehen die inneren Organe viel besser als Experten das Innenleben von KI. Neurowissenschaftler wissen mehr über das Gehirn der KI-Forscher als KI-Forscher über ihre KI, obwohl Neurowissenschaftler nicht in der Lage sind, alle Impulse jedes Neurons jede Sekunde auszulesen, und obwohl die Neurowissenschaftler die KI-Forscher nicht selbst gezüchtet haben.
Dies liegt zum Teil daran, dass die Bereiche Biochemie und Neurowissenschaften viel älter sind und weitaus mehr Fördermittel erhalten haben. Es deutet aber auch darauf hin, dass die Interpretierbarkeit von KI schwierig ist.
Eine der erstaunlichsten Leistungen im Bereich der Interpretierbarkeit, die wir bis Dezember 2024 gesehen haben, war eine Demonstration einiger Freunde/Bekannten von uns in einem unabhängigen Forschungslabor namens Transluce.
Kurz vor der Demo kursierte im Internet ein weiteres Beispiel für "Wir haben eine Frage gefunden, auf die alle bekannten LLMs eine überraschend dumme Antwort geben": Wenn man eine damals aktuelle KI fragte, ob 9,9 kleiner als 9,11 sei, antwortete die KI mit "Ja".
(Und man konnte die KI bitten, ihre Antwort mit Worten zu erklären, woraufhin sie näher erläuterte, warum 9,11 größer als 9,9 ist.)
Die Forscher von Transluce hatten einen Weg gefunden, Statistiken über jede Aktivierungsposition (jeden Ort, an dem eine Aktivierungsvektornummer auftreten könnte) innerhalb einer kleineren KI, Llama 3.1- 8B-Instruct, zu sammeln und Daten darüber zu erfassen, welche Art von Sätzen oder Wörtern diese Positionen am stärksten aktivierten. Leute, die sich mit Interpretierbarkeit beschäftigen, hatten so etwas schon vorher versucht, aber unsere Freunde hatten darüber hinaus eine clevere Methode entwickelt, um eine andere KI zu trainieren, diese Ergebnisse auf Englisch zusammenzufassen.
Dann fragten sie in ihrer Demo, die Sie selbst ausprobieren können, diese KI: "Was ist größer: 9,9 oder 9,11?"
Und die KI antwortete: "9,11 ist größer als 9,9."
Dann suchten sie nach den Aktivierungspositionen, die besonders stark aktiviert worden waren, insbesondere beim Wort "größer". Sie sahen sich die englischen Zusammenfassungen an, mit denen diese Aktivierungen zuvor in Verbindung gebracht worden waren.
Es stellte sich heraus, dass einige der stärksten Aktivierungen mit den Anschlägen vom 11. September, mit Daten im Allgemeinen oder mit Bibelversen in Verbindung standen.
Wenn man 9.9 und 9.11 als Kalenderdaten oder Bibelverse interpretiert, dann kommt 9.11 natürlich nach 9.9.
Unterdrückt man künstlich die Aktivierungen für Kalenderdaten und Bibelverse, gibt das LLM plötzlich doch die richtige Antwort!
Ich (Yudkowsky) begann laut zu applaudieren, sobald die Demo vorbei war. Es war das erste Mal, dass ich jemanden gesehen habe, der einen LLM-Gedanken direkt debuggt, einen inneren Einfluss innerhalb der Zahlen aufspürt und ihn entfernt, um ein Problem zu beheben. Vielleicht hatte jemand zuvor etwas Ähnliches in den firmeneigenen Forschungslabors von KI-Unternehmen getan, oder vielleicht war etwas Ähnliches zuvor in der Interpretierbarkeitsforschung getan worden, aber ich sah es zum ersten Mal selbst.
Ich verlor jedoch auch nicht die Tatsache aus den Augen, dass diese Leistung trivial gewesen wäre, wenn das unerwünschte Verhalten stattdessen in einem fünfzeiligen Python-Programm aufgetreten wäre und dass es nicht so viel Einfallsreichtum und monatelange Forschung erfordert hätte. Ich behielt die Perspektive bei, dass das Wissen über einige verwandte Semantiken zu Millionen von Aktivierungspositionen nicht dasselbe ist wie das Wissen über die Bedeutung einer einzelnen Position.
Auch war die Menschheit kein Stück näher daran zu verstehen, wie es kommt, dass LLMs das tun, was keine KI zuvor jahrzehntelang konnte: mit Menschen wie ein Mensch zu sprechen.
Interpretierbarkeit ist so schwer zu erreichen, dass Erfolge in diesem Bereich so hart erkämpft und so feierenswert sind, dass man leicht übersehen kann, dass dieser große, triumphale Schritt uns nur einen Fuß weiter auf einen tausend Fuß hohen Berg gebracht hat. Da jede neue Generation von KI-Modellen in der Regel einen großen Sprung in der Komplexität darstellt, ist es schwer vorstellbar, dass die Interpretierbarkeit jemals mit dem aktuellen Tempo mithalten kann.
Denken Sie auch daran, dass Interpretierbarkeit nützlich ist, wenn es darum geht, KI in eine bestimmte Richtung zu lenken (was grob gesagt das Thema "KI-Alignment" ist, das wir ab Kapitel 4 behandeln werden), aber wenn man liest, was im Kopf einer KI vor sich geht, kann man sie nicht automatisch nach seinen Wünschen gestalten.
Das Problem des KI-Alignment ist das technische Problem, extrem leistungsfähige KIs in eine bestimmte Richtung zu lenken und zwar so, dass es in der Praxis tatsächlich funktioniert, ohne eine Katastrophe auszulösen, selbst wenn die KI intelligent genug ist, Strategien zu entwickeln, an die ihre Schöpfer nie gedacht hätten. Zu verstehen, was KIs denken, wäre für die Alignmentforschung enorm hilfreich, aber es ist keine vollständige Lösung (wie wir in Kapitel 11 diskutieren werden).
Die Teile, die wir verstehen, befinden sich auf der falschen Abstraktionsebene.
Es gibt viele verschiedene Ebenen, auf denen man verstehen kann, wie ein Geist funktioniert.
Auf der untersten Ebene könnte jemand die grundlegenden Gesetze der Physik verstehen, die den Verstand regieren. In gewisser Weise bedeutet ein tiefes Verständnis der Physik ein Verständnis jedes physikalischen Systems (wie einer Person oder einer KI). Die physikalischen Gleichungen sind nämlich eine Art Rezept, mit dem man genau herausfinden könnte, wie sich das physikalische System verhält, wenn man nur über die Fähigkeiten und Ressourcen verfügen würde, um es zu berechnen.
Aber – um das Offensichtliche zu sagen – in einem anderen Sinne ermöglicht das Verständnis der Gesetze der Physik nicht, alle physikalischen Systeme zu verstehen, die nach den Gesetzen der Physik funktionieren. Wenn Sie auf ein seltsames Gerät voller Räder und Zahnräder starren, führt Ihr Gehirn noch einen weiteren Vorgang durch, nämlich den Versuch, zu "verstehen", wie alle Räder und Zahnräder ineinandergreifen und sich drehen, damit Sie herausfinden können, was alle Räder und Zahnräder tatsächlich bewirken.
Betrachten Sie zum Beispiel das Differential eines Autos (den Mechanismus, der es ermöglicht, dass sich zwei Räder auf derselben Achse mit unterschiedlichen Geschwindigkeiten drehen, was wichtig ist, wenn Sie eine Kurve fahren, während sie weiterhin von einer einzigen rotierenden Welle angetrieben werden). Wenn jemand versucht, die Funktionsweise eines Differentials zu verstehen, und Sie bittet, es ihm zu erklären, und Sie ihm dann etwas über Quantenfelder erzählen, dann ist es nur verständlich, dass er mit den Augen rollt. Die Art von Verständnis, die er sucht, befindet sich auf einer anderen Abstraktionsebene. Er versucht, die Zahnräder zu verstehen, nicht die Atome.
Wenn es darum geht, Menschen zu verstehen, gibt es mehrere Abstraktionsebenen. Man kann Physik, Biochemie und neuronale Impulse verstehen und dennoch von den Entscheidungen einer Person verwirrt sein. Bereiche wie Neurowissenschaften, Kognitionswissenschaften und Psychologie versuchen, diese Lücke zu schließen, aber sie haben noch einen langen Weg vor sich.
Ähnlich verhält es sich mit der KI: Das Verständnis der Funktionsweise von Transistoren hilft niemandem dabei, zu verstehen, was eine KI denkt. Und selbst jemand, der alles über Gewichte, Aktivierungen und Gradientenabstieg versteht, wird immer noch verwirrt sein, wenn die KI etwas tut, was er nicht erwartet oder beabsichtigt hat.* Die Mechanik der Physik und der Transistoren sowie die Architektur der KI erklären (in gewisser Weise) das Verhalten der KI vollständig, aber diese Abstraktionsebenen sind alle zu niedrig. Und das Gebiet der "KI-Psychologie" ist noch jünger und weniger entwickelt als das Gebiet der menschlichen Psychologie.
* Weitere Beispiele für KI, die sich anders verhält als von den Entwicklern erwartet oder beabsichtigt, finden sich in der Diskussion darüber, wie KI psychologisch fremdartig erscheint.
Notes
[1] Pionierarbeit: Ein Beispiel für Gaos Arbeit finden Sie in seinem Artikel mit dem Titel “Scaling and evaluating sparse autoencoders”.
[2] Eine Milliarde Dollar ausgeben: Wir hatten gehofft, dass große philanthropische Stiftungen die Forschung zur Interpretierbarkeit finanzieren würden, da diese Forschung von Forschern mit bürokratisch lesbaren Referenzen gut durchgeführt werden könnte. Die Finanzierung der Interpretierbarkeit würde nicht erfordern, dass die Stiftung das unmöglich schwierige bürokratische Problem löst, wie man Geld an Verrückte verteilt.
“Geld an Verrückte zu geben“ wird von klugen Köpfen allgemein als die grundlegende Herausforderung bei der bürokratischen Finanzierung der wissenschaftlichen Grundlagenforschung angesehen. Immer wenn ein wohlmeinender Philanthrop versucht, eine Bürokratie aufzubauen, um gewagte wissenschaftliche Forschung zu finanzieren, verlieren die echten Wissenschaftler automatisch den Kampf gegen die Neueinsteiger. Jemand, der sein Leben damit verbracht hat, sich mit seltsamen Problemen auseinanderzusetzen, kann kaum mit jemandem konkurrieren, der seine Fähigkeiten darauf verwendet hat, gerade so ungewöhnlich zu wirken, dass ein Bürokrat sich traut, ihn zu finanzieren, ohne sich dabei unwohl zu fühlen. (So lautet zumindest unsere Theorie von außen, nachdem wir uns an diesem Prozess beteiligt haben und mehr philanthropische Mittel erhalten haben als viele andere, aber weit weniger als dieselben philanthropischen Geldgeber für die Einrichtung von KI-Labors wie OpenAI ausgegeben haben.)