"Offensichtliche" Erkenntnisse brauchen Zeit
Es ist schwierig, Erkenntnisse in der KI zu gewinnen, selbst wenn sie im Nachhinein einfach und offensichtlich erscheinen.
Das ist wichtig zu verstehen, denn um KI richtig einzusetzen, sind wahrscheinlich viele Erkenntnisse erforderlich. Auch wenn sie im Nachhinein einfach klingen mögen, kann es manchmal Jahrzehnte dauern, bis solche Erkenntnisse gewonnen werden.
Zu diesem Zweck werden wir einige der Erkenntnisse hervorheben, die moderne KI-Systeme antreiben.
Wenn Sie beispielsweise über Programmierkenntnisse verfügen, lesen Sie vielleicht Kapitel 2 des Buches und denken, dass diese "Gradientenabstiegsmethode" so einfach klingt, dass Sie sie sofort ausprobieren könnten. Wenn Sie das tun würden, würden Sie jedoch wahrscheinlich schnell auf einen Fehler stoßen. Möglicherweise würde Ihr Programm aufgrund eines Fließkommafehlers abstürzen, weil die Zahlen in einem der Gewichte zu groß geworden sind.
Im 20. Jahrhundert wusste noch niemand, wie man Gradientenabstieg in einem neuronalen Netzwerk mit mehreren Zwischenwertschichten zwischen Eingabe und Ausgabe zum Laufen bringt. Um Probleme zu vermeiden, mussten Programmierer alle möglichen Tricks lernen, wie zum Beispiel die Gewichte auf raffinierte Weise zu initialisieren, damit sie nicht zu groß werden. Anstatt beispielsweise alle Gewichte mit einer Zufallszahl zwischen 0 und 1 (oder einer Zufallszahl mit einem Mittelwert von 0 und einer Standardabweichung von 1) zu initialisieren, müssen Sie die Gewichte so initialisieren und sie dann alle durch eine Konstante dividieren, die dafür sorgt, dass die Zahlen der nächsten Schicht während des Betriebs ebenfalls nicht zu groß werden.
Die Gradientenabstiegsmethode stößt auf Probleme, wenn sie auf komplizierte Formeln mit vielen Schritten oder "Schichten" angewendet wird, und die Division der anfänglichen Zufallszahlen durch eine Konstante ist eine der wichtigsten Ideen, die "Deep Learning" ermöglichen. Dieser Trick wurde erst sechs Jahrzehnte nach der ursprünglichen Vorstellung neuronaler Netze im Jahr 1943 erfunden.
Die Idee, die Parameter mit Hilfe der Infinitesimalrechnung zu optimieren, wurde erstmals 1962 diskutiert und 1967 erstmals auf das Konzept der neuronalen Netze mit mehr als einer Schicht angewendet. Wirklich populär wurde sie jedoch erst durch eine Veröffentlichung aus dem Jahr 1986 (die Geoffrey Hinton mitverfasst hat, was einer der Gründe ist, warum er als "Godfather of AI" bezeichnet wird). Beachten Sie jedoch, dass die allgemeinere Idee, Differentialrechnung auf differenzierbare Fragen anzuwenden, um zu einer richtigen Antwort zu gelangen, z.B. um eine Quadratwurzel zu berechnen, von Isaac Newton erfunden wurde.
Ein weiterer wichtiger Trick ist der folgende. Im Buch geben wir ein Beispiel für Gradientenabstiegsoperationen:
Ich multipliziere jede Eingangs-Zahl mit dem Gewicht im ersten Parameter, addiere sie dann zum Gewicht im zweiten Parameter, ersetze sie durch Null, wenn sie negativ ist, und dann ...
Diese Liste von Operationen ist kein Fehler. Multiplikation, Addition und "Ersetzen durch Null, wenn negativ" sind mehr oder weniger die drei entscheidenden Operationen in einem neuronalen Netzwerk. Die ersten beiden sind die Operatoren, aus denen sich eine "Matrixmultiplikation" zusammensetzt, und der letzte führt eine "Nichtlinearität" ein und ermöglicht es dem Netzwerk dadurch, nichtlineare Funktionen zu lernen.
Die Formel für "ersetze es durch Null, wenn es negativ ist" lautet
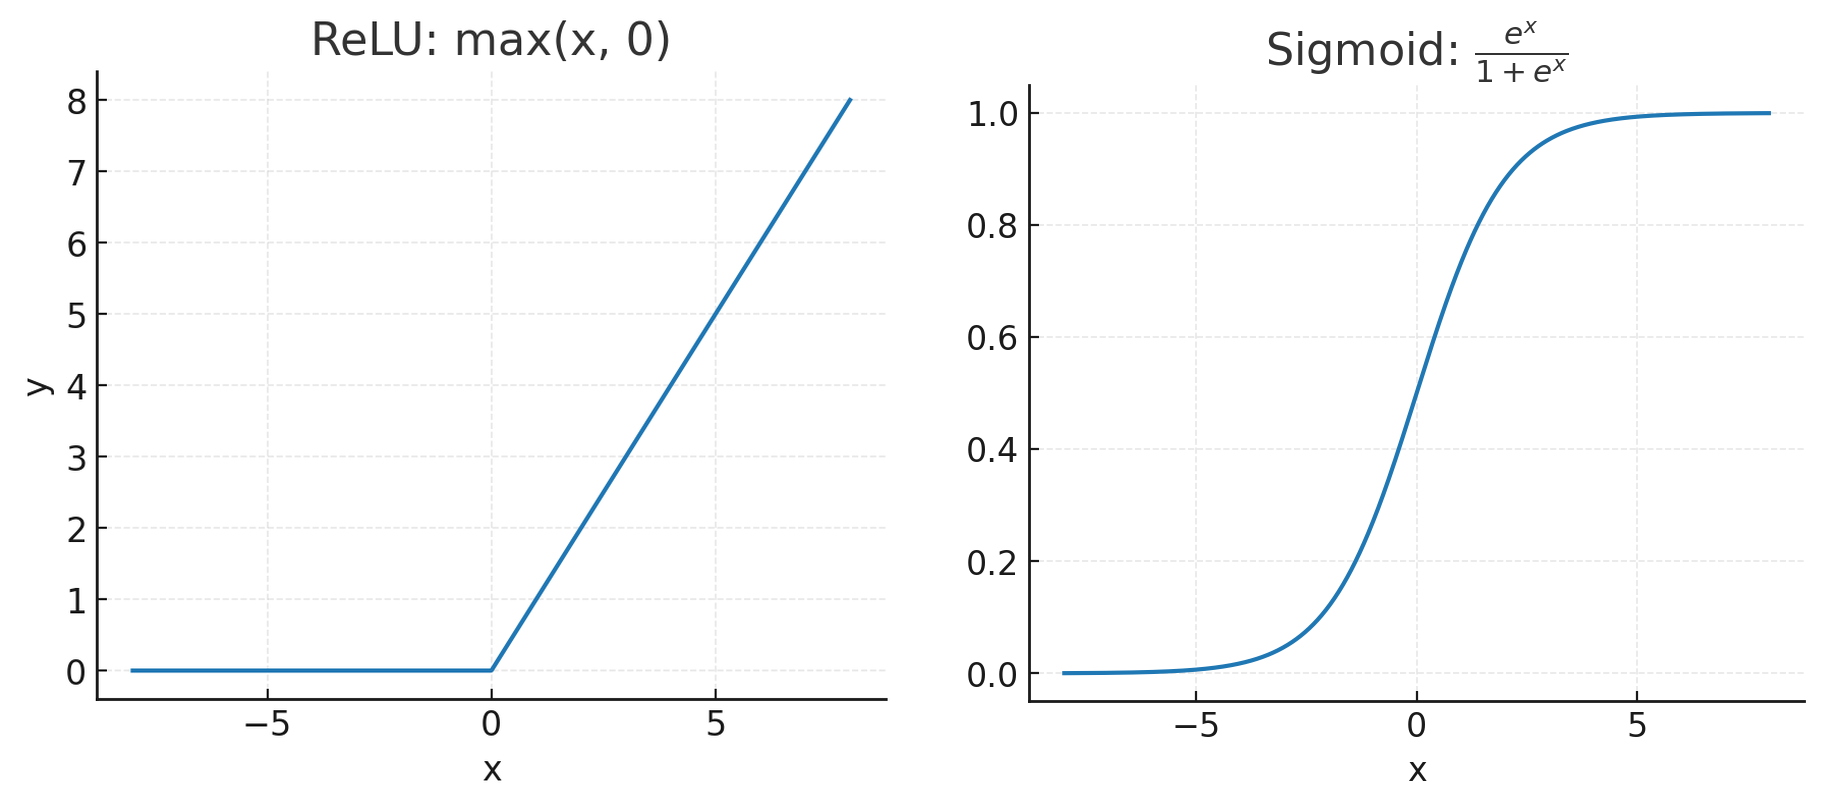
Es gab gute Gründe für die Annahme, dass die kompliziertere "Sigmoid"-Formel funktionieren würde! Oberflächlich betrachtet sorgt sie dafür, dass die Ausgabewerte auf sinnvolle Weise und gleichmäßig zwischen 0 und 1 liegen, und aus einer tieferen Perspektive betrachtet hat sie einige nützliche Verbindungen zur Wahrscheinlichkeitstheorie. Selbst einige moderne tiefe neuronale Netze verwenden in einigen Schritten etwas Ähnliches wie eine Sigmoid-Funktion. Wenn Sie jedoch nur eine Nichtlinearität verwenden möchten, funktioniert eine ReLU viel besser.
Das Problem mit der Sigmoid-Formel ist, dass sie dazu neigt, viele der Ausgabewerte mit sehr kleinen Gradienten zu erzeugen. Und wenn die meisten Gradienten sehr klein sind, funktioniert der Gradientenabstieg nicht mehr ... zumindest nicht, wenn man nicht den modernen Trick kennt, größere Gradientenschritte zu machen, wenn kleine Gradienten immer in die gleiche Richtung zeigen. (Unseres Wissens nach tauchte dieser Trick erstmals 2012 in der Literatur auf, als er von Geoffrey Hinton vorgeschlagen wurde.)
"Machen Sie Ihre anfänglichen Zufallszahlen kleiner, damit ihre multiplizierten Summen nicht zu groß werden", "verwenden Sie max(x, 0) anstelle einer komplizierten Formel" und "machen Sie größere Schritte, wenn winzige Gradienten immer in die gleiche Richtung zeigen" mögen wie seltsam einfache Ideen klingen, die jahrzehntelang nicht erfunden wurden, vor allem, weil sie im Nachhinein für einen Computerprogrammierer, der all diese Dinge versteht, offensichtlich erscheinen. Dies ist eine wichtige Lektion für die Art und Weise, wie Wissenschaft und Technik im wirklichen Leben funktionieren.
Selbst wenn es eine einfache und praktische Lösung für eine technische Herausforderung gibt, finden Forscher sie oft erst, nachdem sie jahrzehntelang versucht und versagt haben. Man kann sich nicht darauf verlassen, dass Forscher eine Lösung sofort erkennen, sobald sie wichtig wird. Man kann sich nicht darauf verlassen, dass sie sie innerhalb der nächsten zwei Jahre erkennen. Selbst wenn eine Lösung im Nachhinein offensichtlich erscheint, stolpert das Fachgebiet manchmal jahrzehntelang ohne sie vor sich hin.
Später wird dies eine nützliche Lektion sein, die man im dritten Teil des Buches im Hinterkopf behalten sollte, wenn wir darüber sprechen, wie schlecht die Menschheit auf die Herausforderung durch Superintelligenz vorbereitet ist.
Wenn der Preis dafür, dass einige verrückte Erfinder vorpreschen, darin besteht, dass alle Menschen auf der Erde während dieser schwierigen Anfangsphase sterben, dann können wir sie nicht vorpreschen lassen. Die Erfinder werden protestieren, dass sie keine Möglichkeit haben, eine einfache, robuste Lösung zu finden, ohne sich einige Jahrzehnte lang vorwärts tasten zu dürfen, sie werden sagen, dass es unrealistisch ist, von ihnen zu erwarten, dass sie die Lösung im Voraus finden.
Hoffentlich ist jedem, der kein verrückter Erfinder ist, klar, dass wir ihre Bemühungen unterbinden sollten, wenn diese Behauptungen wahr sind.
Aber das ist ein Thema, das wir in Teil III des Buches wieder aufgreifen werden, nachdem wir die Argumentation abgeschlossen haben, dass künstliche Superintelligenz Mittel, Motiv und Gelegenheit hätte, die Menschheit auszulöschen. Vorerst wenden wir uns dem Thema zu, wie "offensichtliche" Ideen wie die, die wir bisher diskutiert haben und einige Ideen, die etwas weniger offensichtlich sind, zusammenkommen, um ein tatsächlich funktionierendes KI-Modell zu schaffen.
* Neuere Architekturen werden komplexere Funktionen verwenden. Die unten beschriebene Llama 3.1-Architektur verwendet beispielsweise die “SwiGLU”-Funktion, deren komplizierte Formel wir hier nicht wiedergeben werden.